Как я собирал датасет дорожных знаков: от видеорегистратора до автоматической разметки
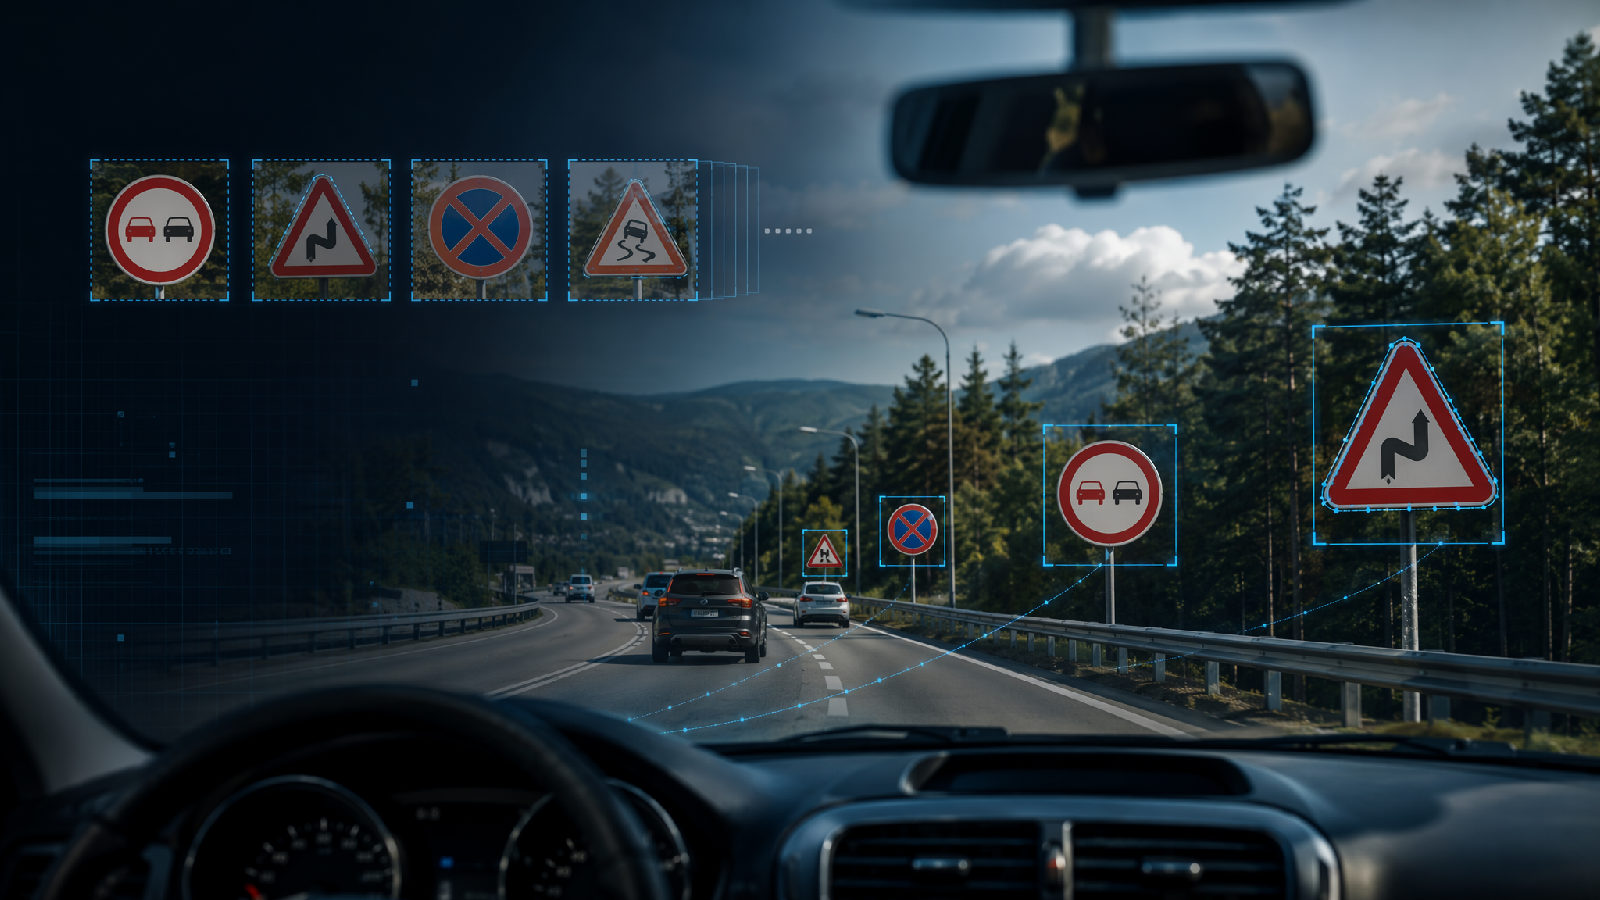
В рамках личного проекта я решил разработать систему детекции дорожной инфраструктуры. Начать решил с дорожных знаков: задача выглядела понятной, а результат было легко проверить визуально. Первоначальный план действительно был простым — записать видео, разбить его на кадры, обвести знаки и обучить модель. Как я ошибался))
Сначала я, как и многие, попытался найти готовые датасеты российских дорожных знаков. Доступные варианты не закрыли мои требования: нужны были свои классы, реальные записи с видеорегистраторов и возможность постоянно пополнять данные новыми маршрутами и условиями съёмки. Поэтому я принял мучительное решение собрать собственный набор данных.
В статье расскажу, как из небольшого эксперимента выросли отдельное приложение для разметки, классификатор для проверки объектов, сегментатор для уточнения рамок и собственный трекер. Это история проекта, а не универсальный рецепт: все пороги и архитектурные решения подбирались под мои видео, классы и доступное время. Технические детали и числа относятся к состоянию проекта на момент подготовки статьи.
Есть желание — вперёд
Итак, есть желание — вперёд! Первично думал: есть машина, есть видеорегистратор — что может быть проще? Едем по дороге, записываем видео, разбиваем на кадры, отмечаем знаки, и вуаля — датасет готов. Но уже первые записи показали, что основная работа находится не в обучении нейросети, а в подготовке данных и борьбе с однотипными ошибками.
Начну с того, о чём я не думал в самом начале:
- Данные с одного видеорегистратора не подходят. У большинства устройств широкий объектив и своя коррекция геометрии. Угол обзора и искажения особенно заметны по краям кадра, поэтому один и тот же знак выглядит по-разному.
- Пришлось использовать три разных видеорегистратора с разным разрешением и углом обзора. Это увеличило разнообразие изображений, но добавило различий в резкости, цвете и деформации объектов.
- Нужны кадры в разное время года. Меняется не только цветовая палитра, но и фон, освещение и видимость знаков. Отдельные ситуации — дождь, снегопад и загрязнение оптики.
- Один знак остаётся в кадре на протяжении длинной последовательности. Если сохранять всё подряд, датасет быстро раздувается почти одинаковыми изображениями, а ручная разметка превращается в бесконечную работу.
- Где и как размечать — отдельный вопрос. Недостаточно один раз обвести объект: нужно исправлять классы, удалять ложные срабатывания, уточнять границы и находить собственные пропуски.
Главная сложность оказалась не в том, чтобы получить много кадров, а в том, чтобы превратить их в полезные и проверяемые примеры.
Первый прототип и ручная разметка
Начал с минимального набора. На небольшом количестве данных обучил первый детектор и использовал его для поиска кандидатов на новых кадрах. Так появился рабочий цикл: модель предлагает разметку, я исправляю её, пополняю датасет и запускаю следующее обучение.
Но у маленького датасета быстро проявилась обратная сторона. Детектор находил не только знаки, но и похожие по форме или цвету объекты: колёса автомобилей, элементы конструкций, обратные стороны знаков, светофоры и случайные фрагменты фона. Рамки вокруг настоящих знаков тоже были неточными: в них попадал столб, соседние объекты или большой кусок окружающей сцены.
На этом этапе я понял, что нельзя оценивать досбор данных только количеством новых аннотаций. Если автоматически принять все предложения модели, следующий цикл обучения закрепит ошибки предыдущего. Автоматизация должна была сокращать ручную работу, но не отменять проверку.
Зачем я написал своё приложение
Для работы с видео и подготовки датасета я собрал отдельное приложение на Python и wxPython. Оно постепенно обросло функциями, которых мне не хватало в повседневной работе. В проект можно загрузить набор изображений или видео, пройти по кадрам, создать и изменить прямоугольник, назначить класс, удалить ошибочную аннотацию и отметить фоновый кадр.
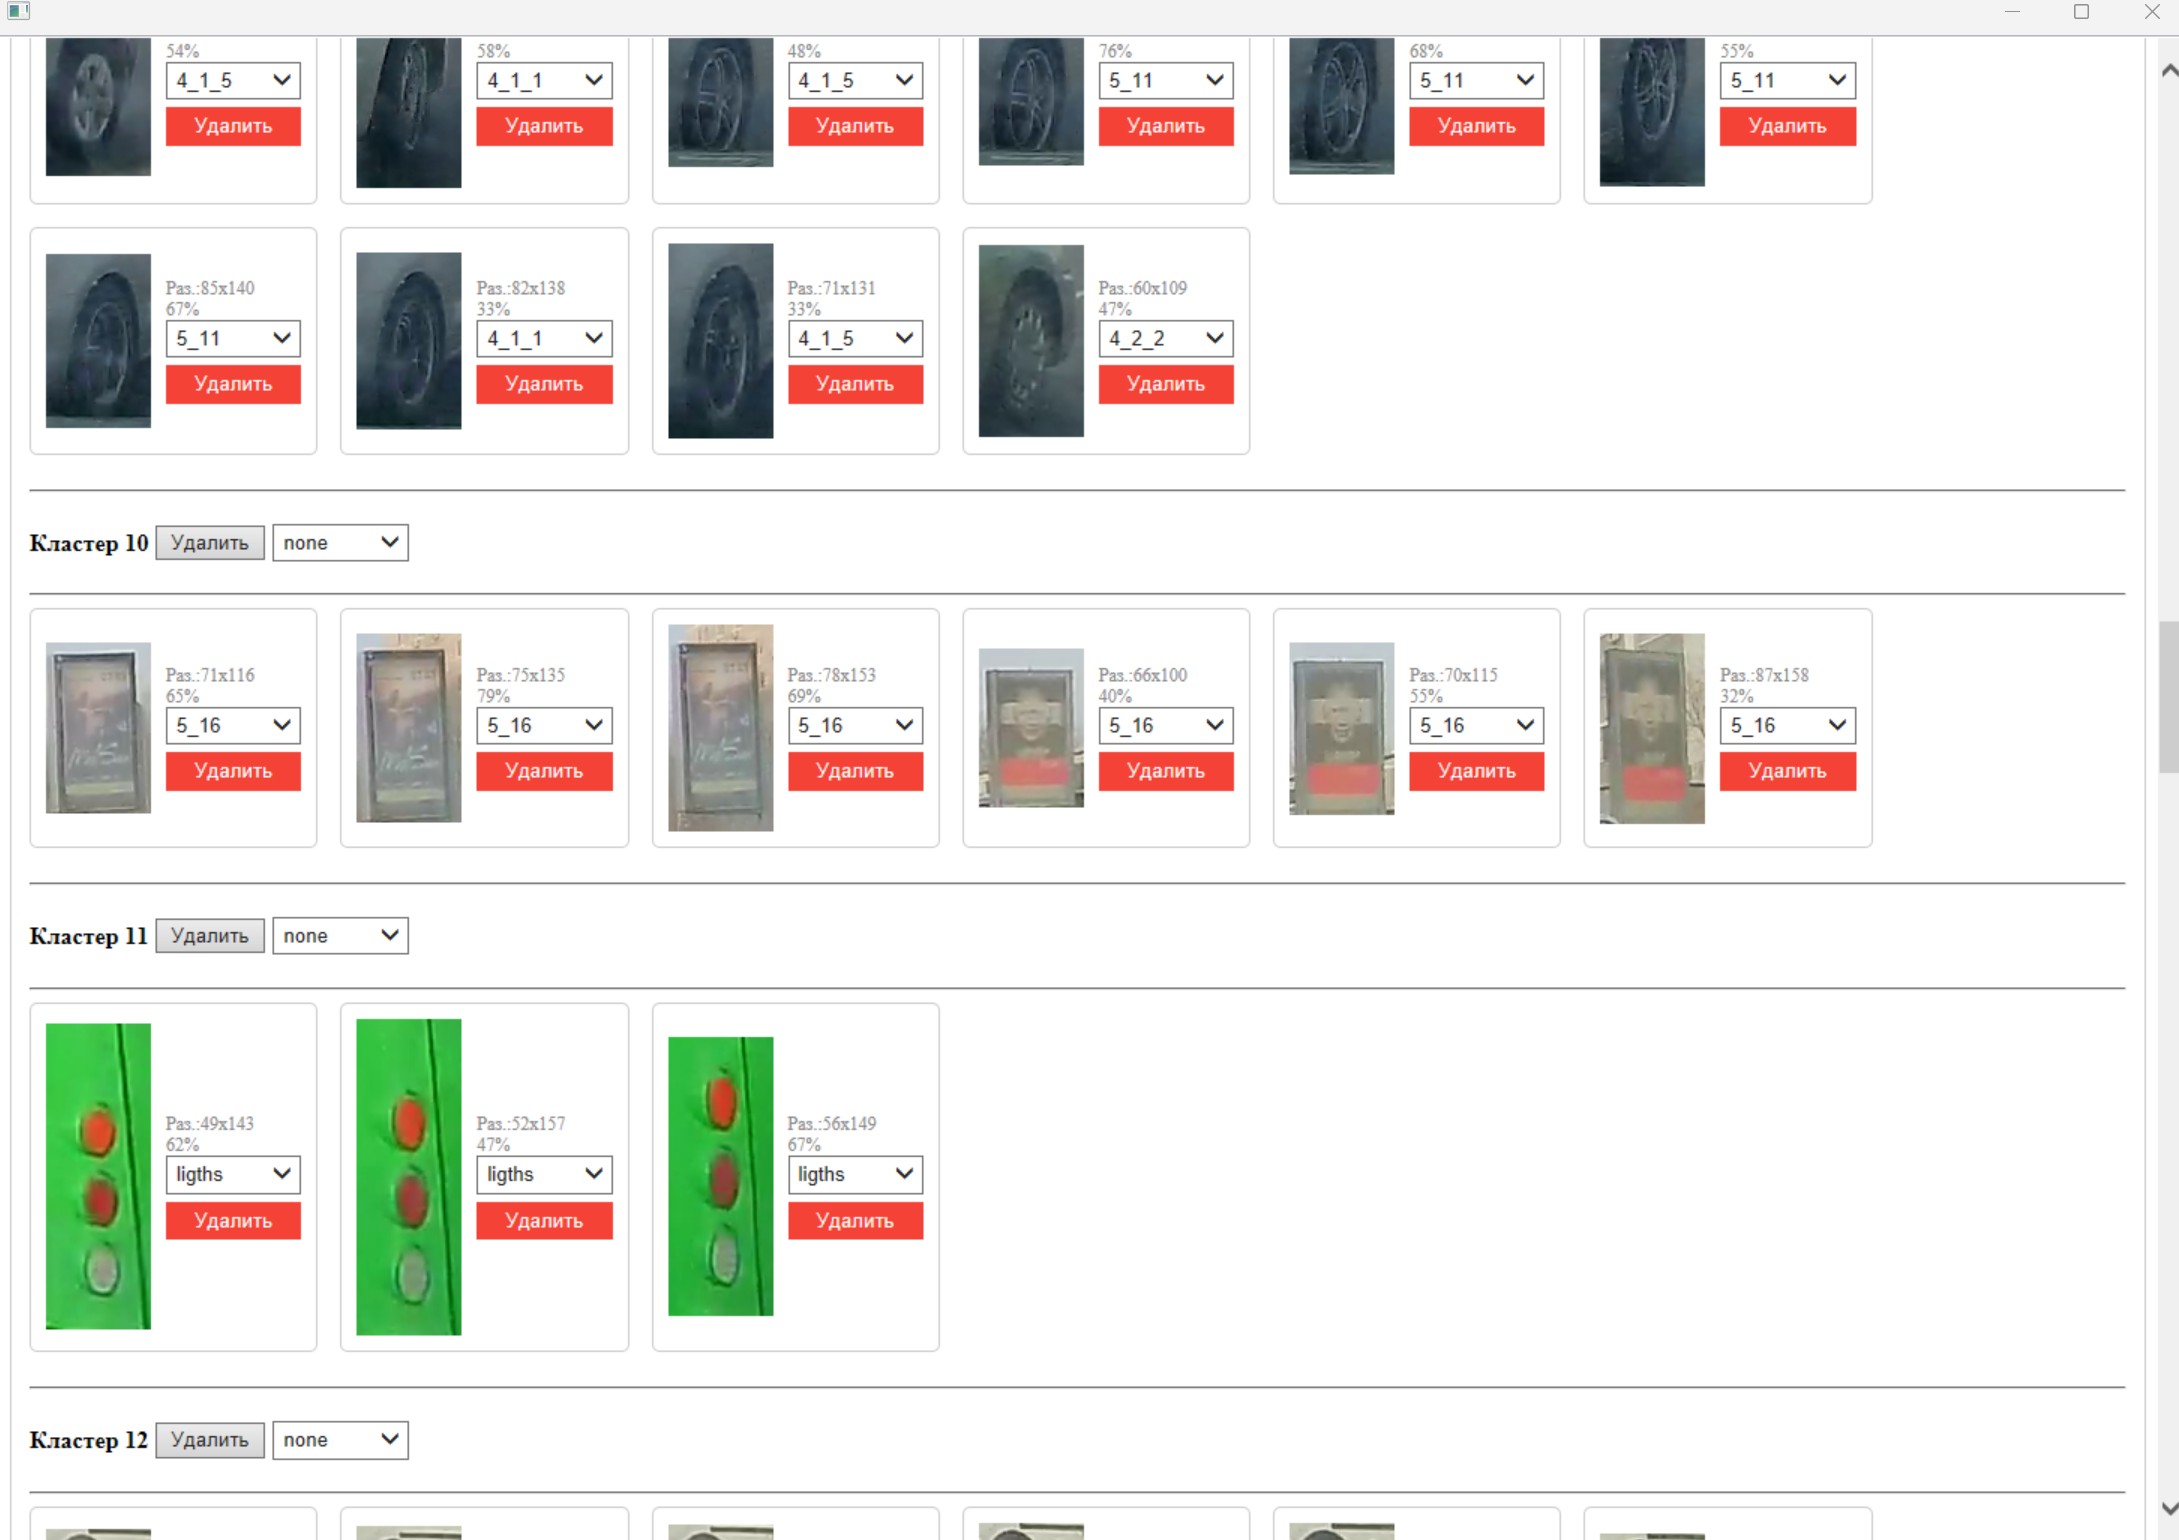
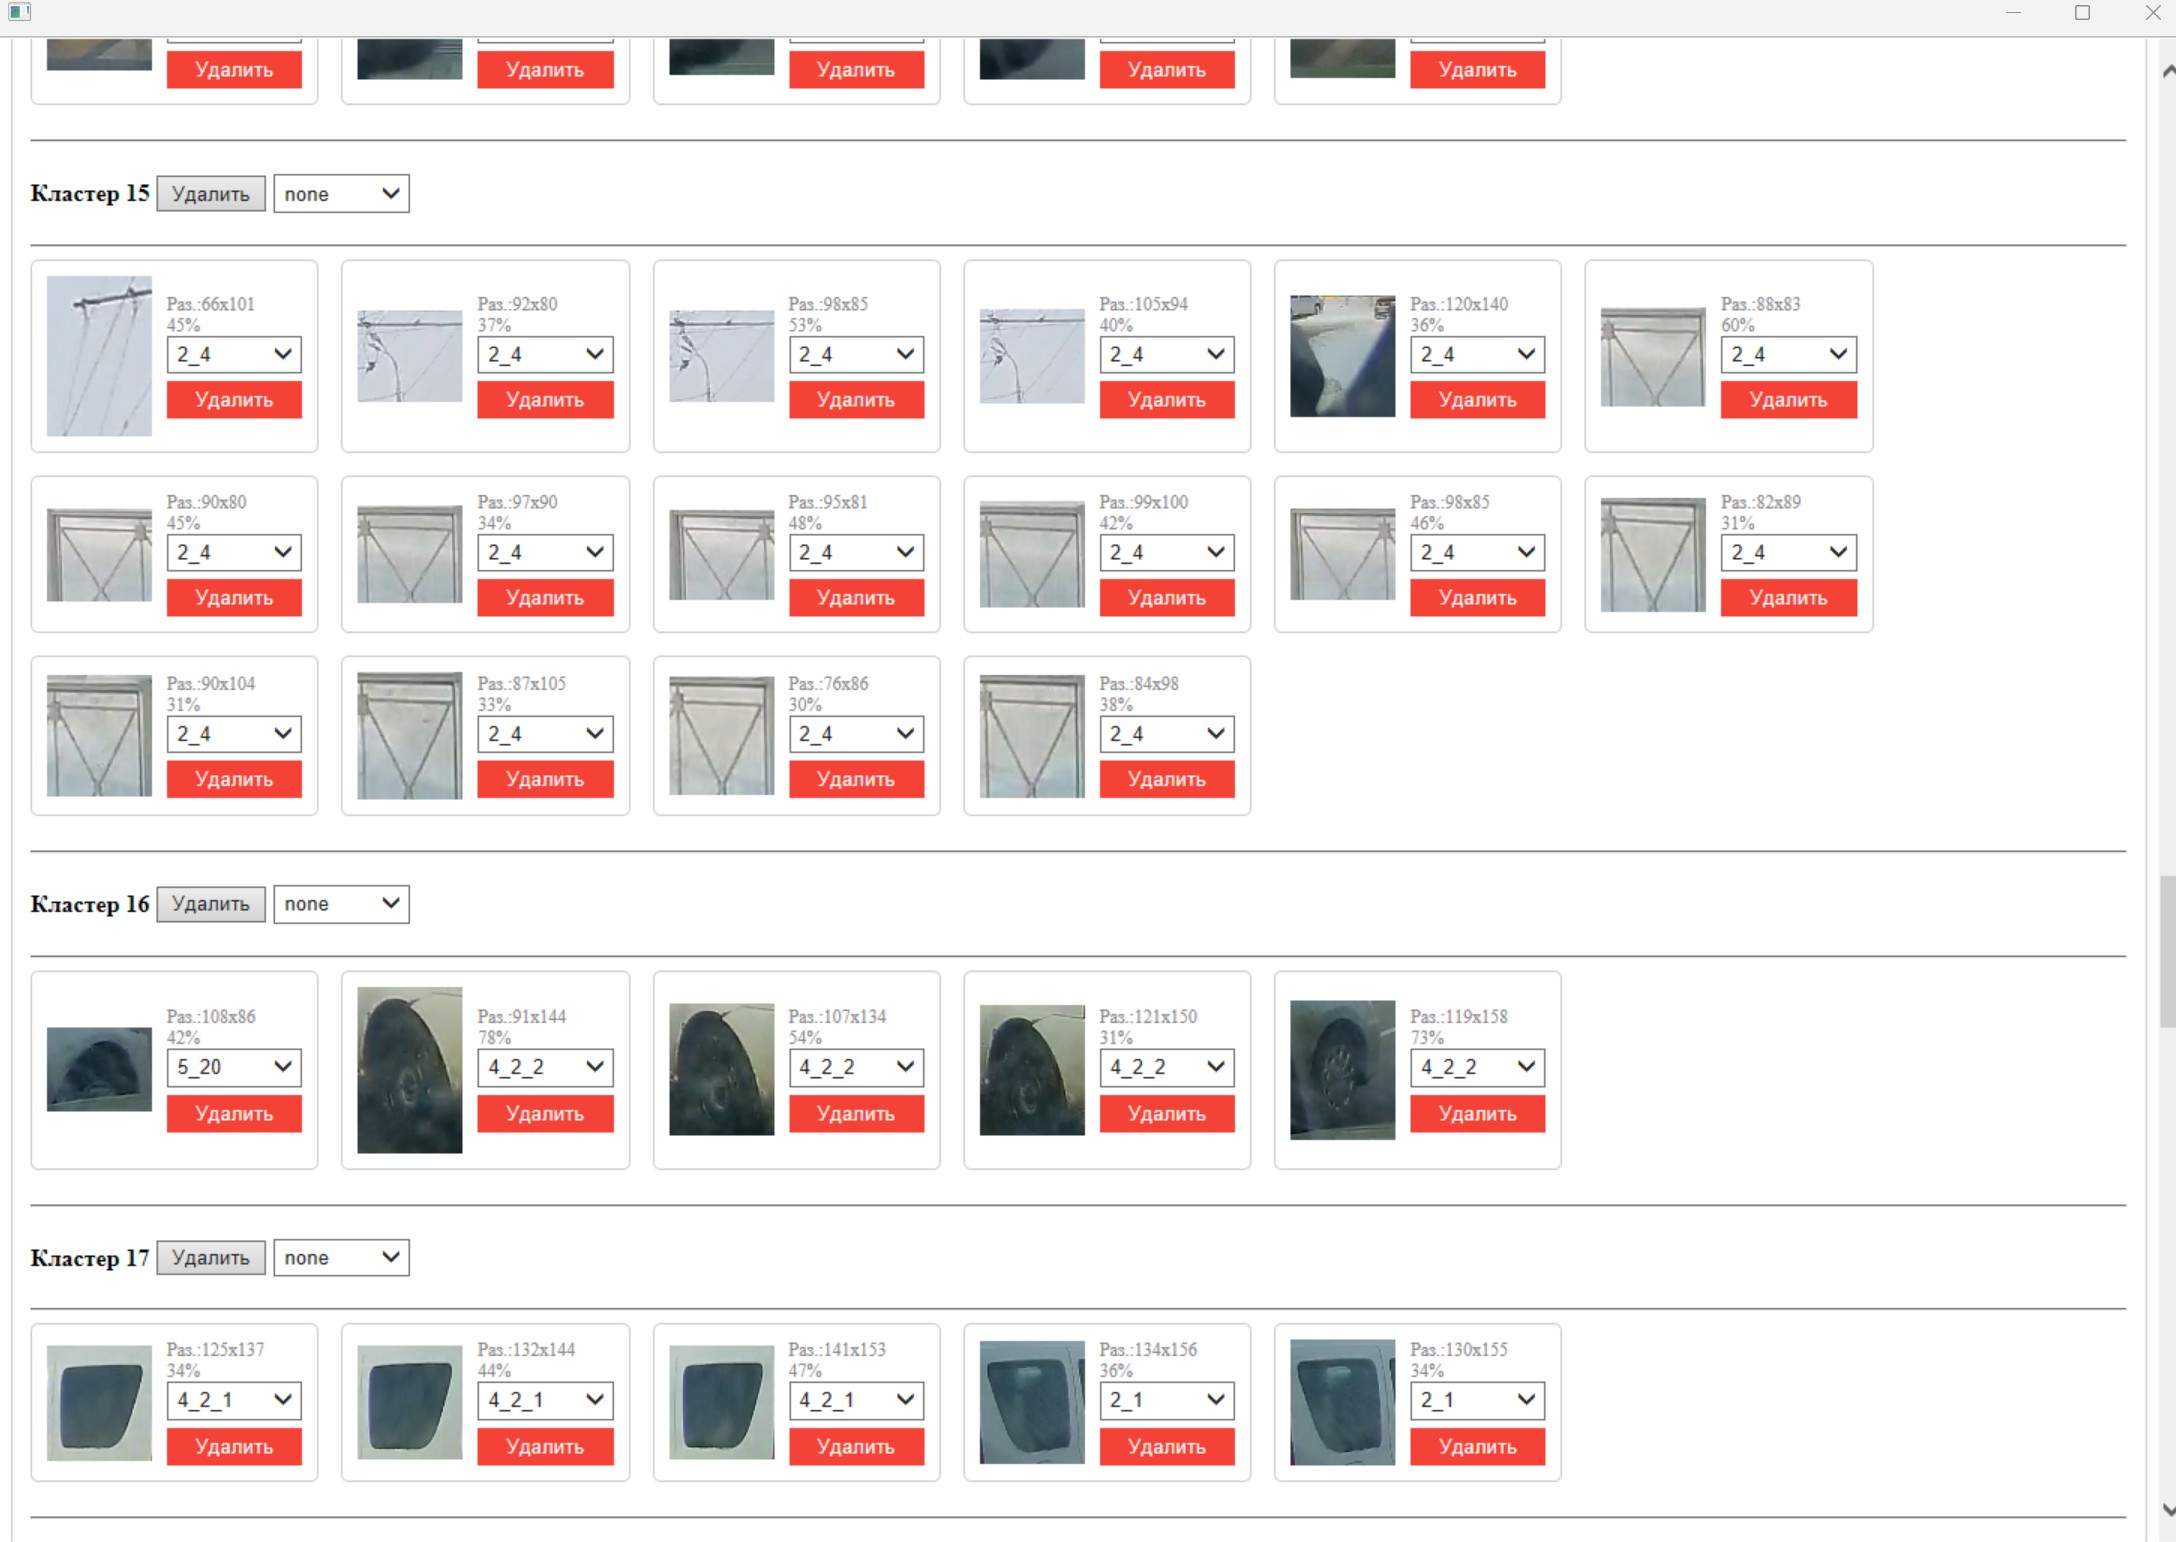
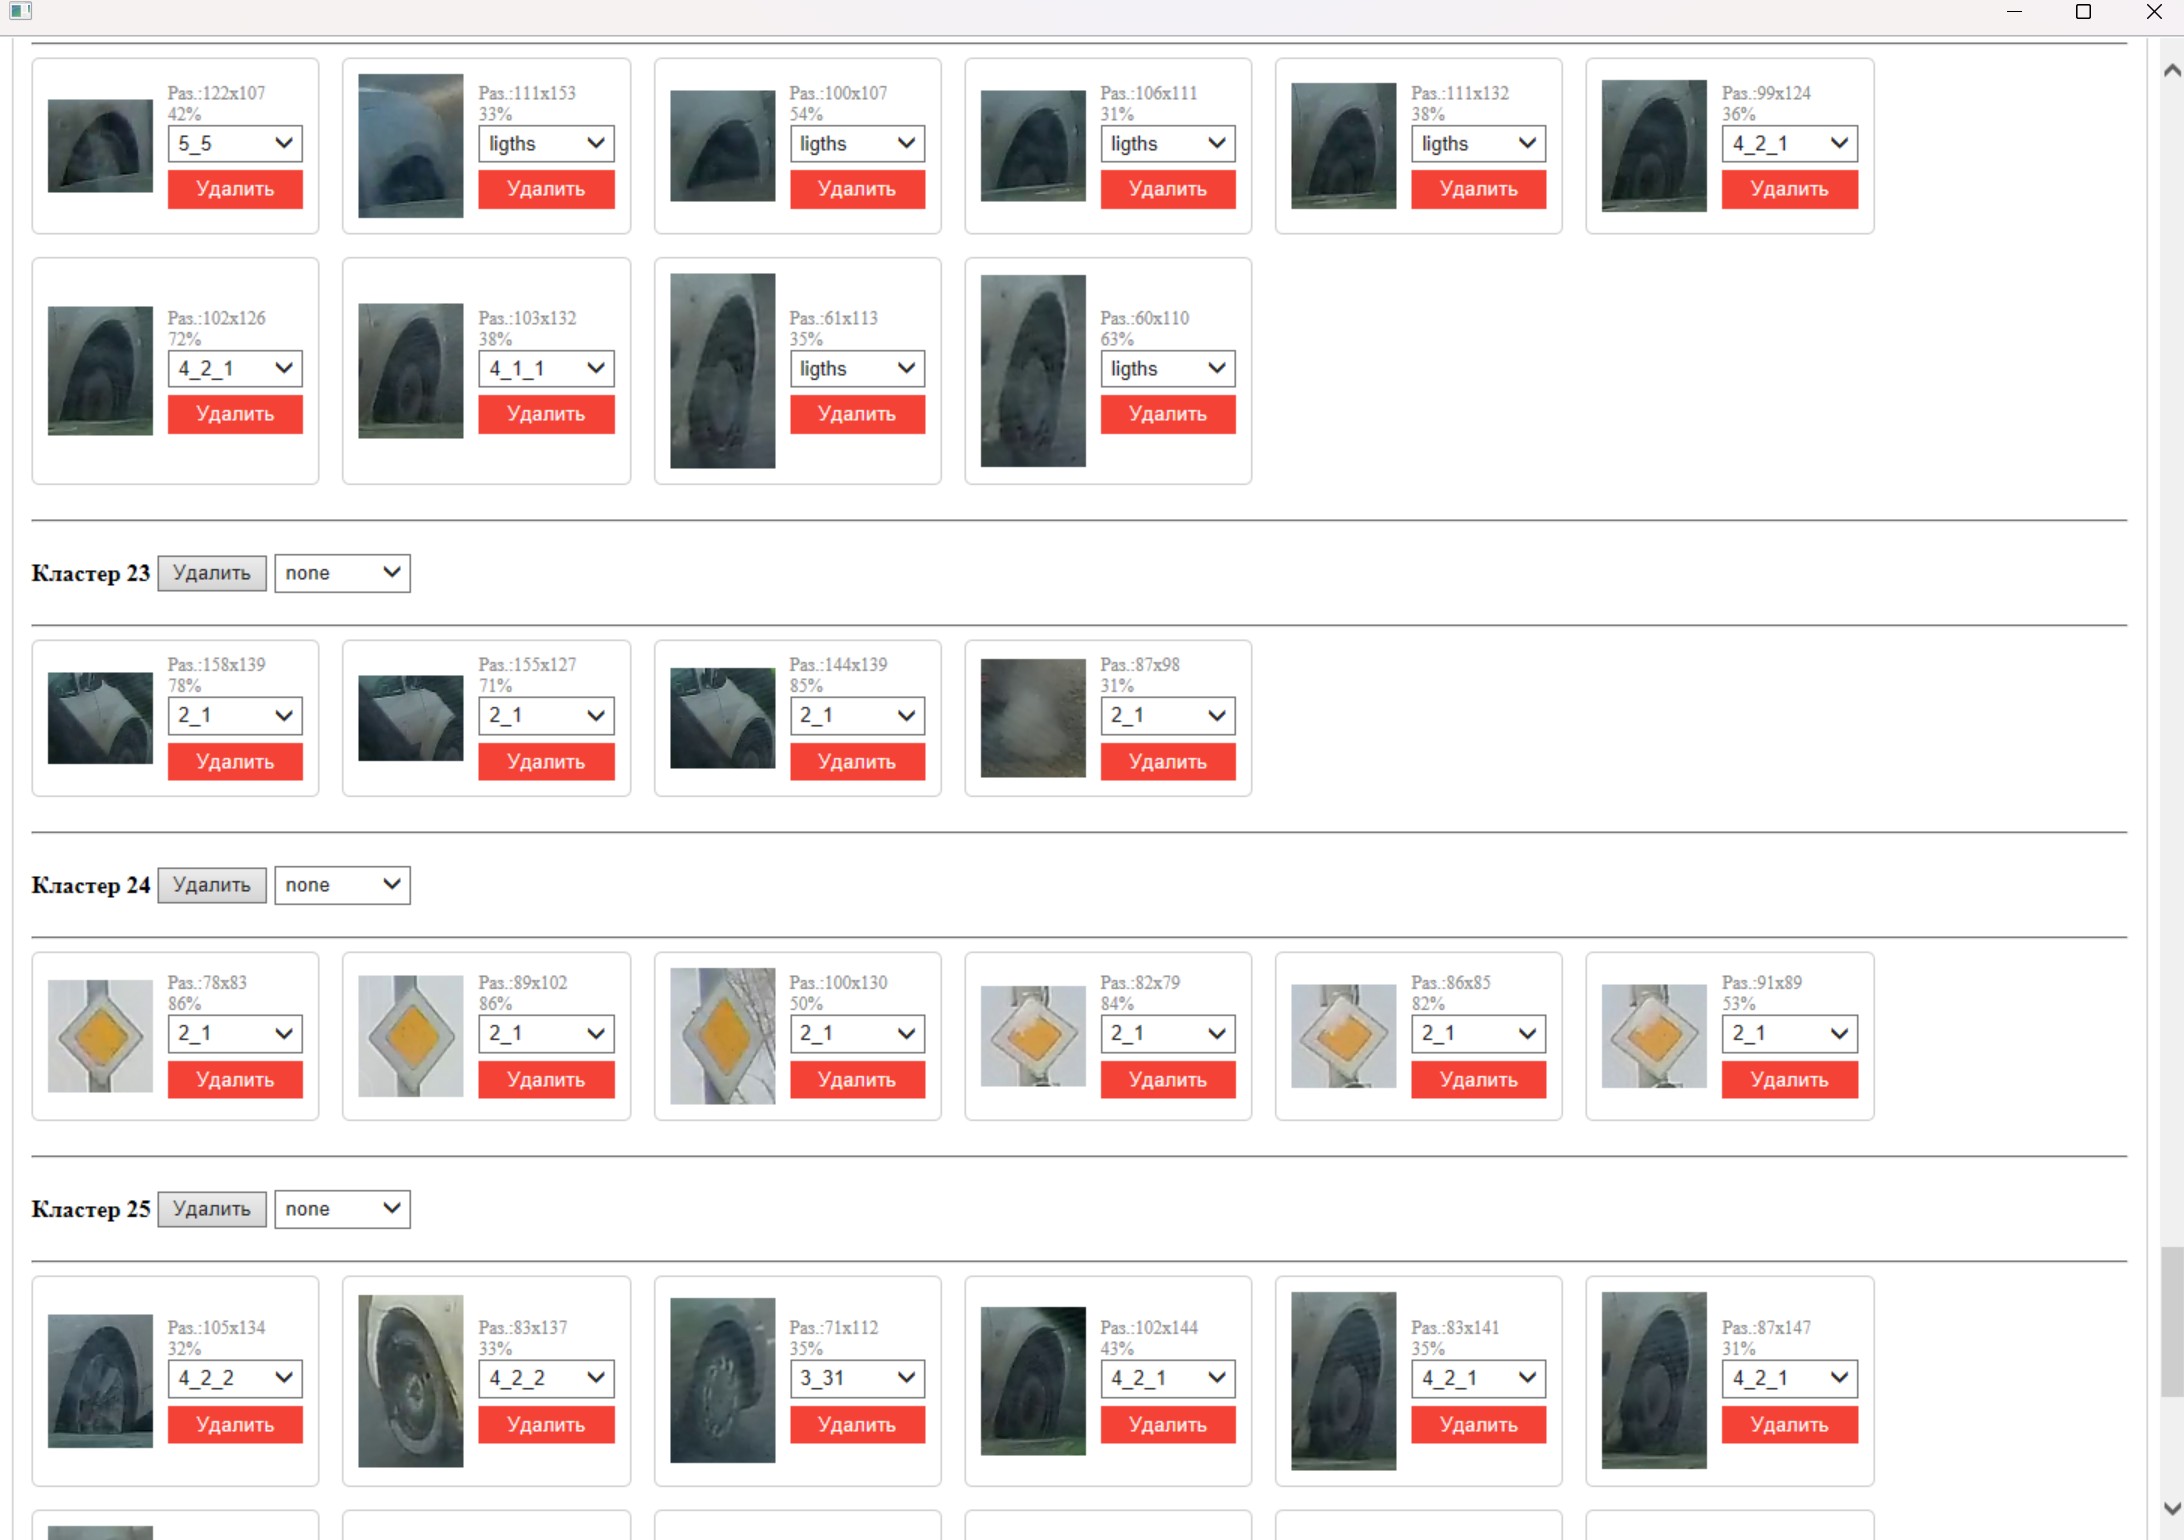
Приложение работает с собственной моделью проекта: для каждого кадра хранятся идентификатор, размеры и список аннотаций, а для видео вместо имени изображения используется номер кадра. Для просмотра большого количества объектов я добавил отдельное представление по классам и кластерам. В нём можно перейти к исходному кадру, изменить класс одного объекта или целой группы и удалить ложные детекции.
Отдельный экспорт формирует структуру YOLO: images/train, images/val, labels/train, labels/val и YAML-файл с именами классов. Координаты прямоугольников нормализуются под размер кадра. Экспорт также учитывает размер исходных изображений и ограничивает чрезмерно большие классы, чтобы частые объекты полностью не подавляли остальные.
Со временем в тот же контур были подключены детектор, классификатор и сегментатор. В результате приложение стало не просто редактором разметки, а рабочим местом для итеративного досбора данных: сначала обрабатываю видео моделями, затем разбираю спорные места вручную и только после этого формирую очередную версию набора.
Кластеризация: ускорить проверку, а не отменить её
Когда объектов стало много, проверять их по одному оказалось неудобно. Я решил группировать похожие изображения: если в кластере видны только колёса или только обратные стороны знаков, такую группу проще удалить целиком. Если же внутри однородной группы находится один другой класс, ошибка заметна значительно лучше, чем в общем списке.
Для группировки использовал не сами пиксели, а признаки из классификатора YOLO. В текущей реализации эмбеддинг снимается с промежуточного слоя модели, после чего кластеризатор объединяет объекты по этим признакам.
Небольшая подводка: что здесь делают алгоритмы
Кластеризация решает другую задачу, чем классификация. Классификатор отвечает на вопрос «какой это объект?», а кластеризатор — «какие изображения похожи между собой?». Название класса для каждой группы заранее не требуется: алгоритм ищет группы по близости признаков, а я уже проверяю их содержимое.
У алгоритмов разные требования к настройке. Одним нужно заранее указать число кластеров, другие определяют его по данным. Второй вариант был для меня предпочтительнее: я заранее не знал, какие знаки, посторонние объекты и ошибки найдёт детектор на новом видео.
Какие алгоритмы я пробовал
- K-means разбивает объекты на заранее заданное число кластеров. Алгоритм работает, но это число приходится угадывать. Слишком маленькое оставляет много ручной работы внутри смешанных групп. Слишком большое дробит данные, и проверять приходится почти столько же групп, сколько исходных объектов.
- Affinity propagation сам определяет число групп и выделяет характерные примеры, вокруг которых они строятся. Алгоритм дал один из лучших результатов и потребовал от меня минимума настроек. В черновике я отметил хорошую работу на 250 итерациях; в текущей версии приложения установлен предел 350 итераций. Это не универсальная настройка, а рабочая точка для моего набора.
- MeanShift ищет области повышенной плотности и тоже не требует заранее задавать число кластеров. Он работал, но приходилось подбирать quantile для оценки bandwidth — ширины области, в которой измеряется плотность. Эта настройка занимала время и заметно влияла на результат.
- DBSCAN объединяет плотно расположенные точки и умеет отделять выбросы как шум. На моих данных он показал плохие результаты: подобрать размер окрестности так, чтобы группы были одновременно чистыми и полезными, мне не удалось.
Проблема, однако, была не только в алгоритме кластеризации. Если детектор неточно очертил объект, классификатор получает нечистый вход: часть знака, столб, фон или соседнюю конструкцию. В такой ситуации ни признаки, ни группировка не могут надёжно восстановить смысл изображения. Поэтому качество исходных рамок напрямую влияло на качество всей последующей автоматизации.
Классификатор стал вторым фильтром после детектора
Следующим шагом я обучил отдельный классификатор для уже вырезанных объектов. Его задача отличалась от задачи детектора: не найти объект на полном кадре, а оценить небольшой кроп и ответить, что именно попало в рамку. Среди классов появились не только знаки, но и фон и ошибочные объекты.
Сначала попробовал yolo11n-cls. Она классифицировала знаки, но в моём случае недостаточно хорошо отделяла их от других объектов. После перехода на yolo11s-cls фильтрация заработала заметно лучше. В текущем обучающем скрипте используются изображения 96 × 96, 90 эпох, batch 64 и отключённое горизонтальное отражение. Последнее важно: зеркалирование способно изменить смысл части дорожных знаков.
На 90-й эпохе эксперимента train8 accuracy top-1 составила 98,36%, top-5 — 99,78%. Для текущего контура важна не только точность распознавания знаков, но и способность модели отделять их от фона и ложных детекций.
Наличие классификатора позволило снизить порог срабатывания детектора и получать больше кандидатов. В текущем контуре детекция идёт с conf = 0,30, после чего классификатор уточняет класс и отбраковывает фон. Соответственно, я сознательно разделил два решения: сначала найти как можно больше возможных объектов, затем отсеять лишнее отдельной моделью.
Этот же классификатор дал признаки для кластеризации и рекомендаций. Последний этап я добавил, чтобы не пропускать собственные ошибки при большом потоке объектов. Приложение сравнивает исходный класс аннотации с предсказанным и показывает расхождения отдельно. Если новый класс — background, объект предлагается к удалению; если другой знак — к смене класса. Но это именно рекомендации: сначала я вручную проверяю, как они работают, и только потом автоматизирую следующие действия.
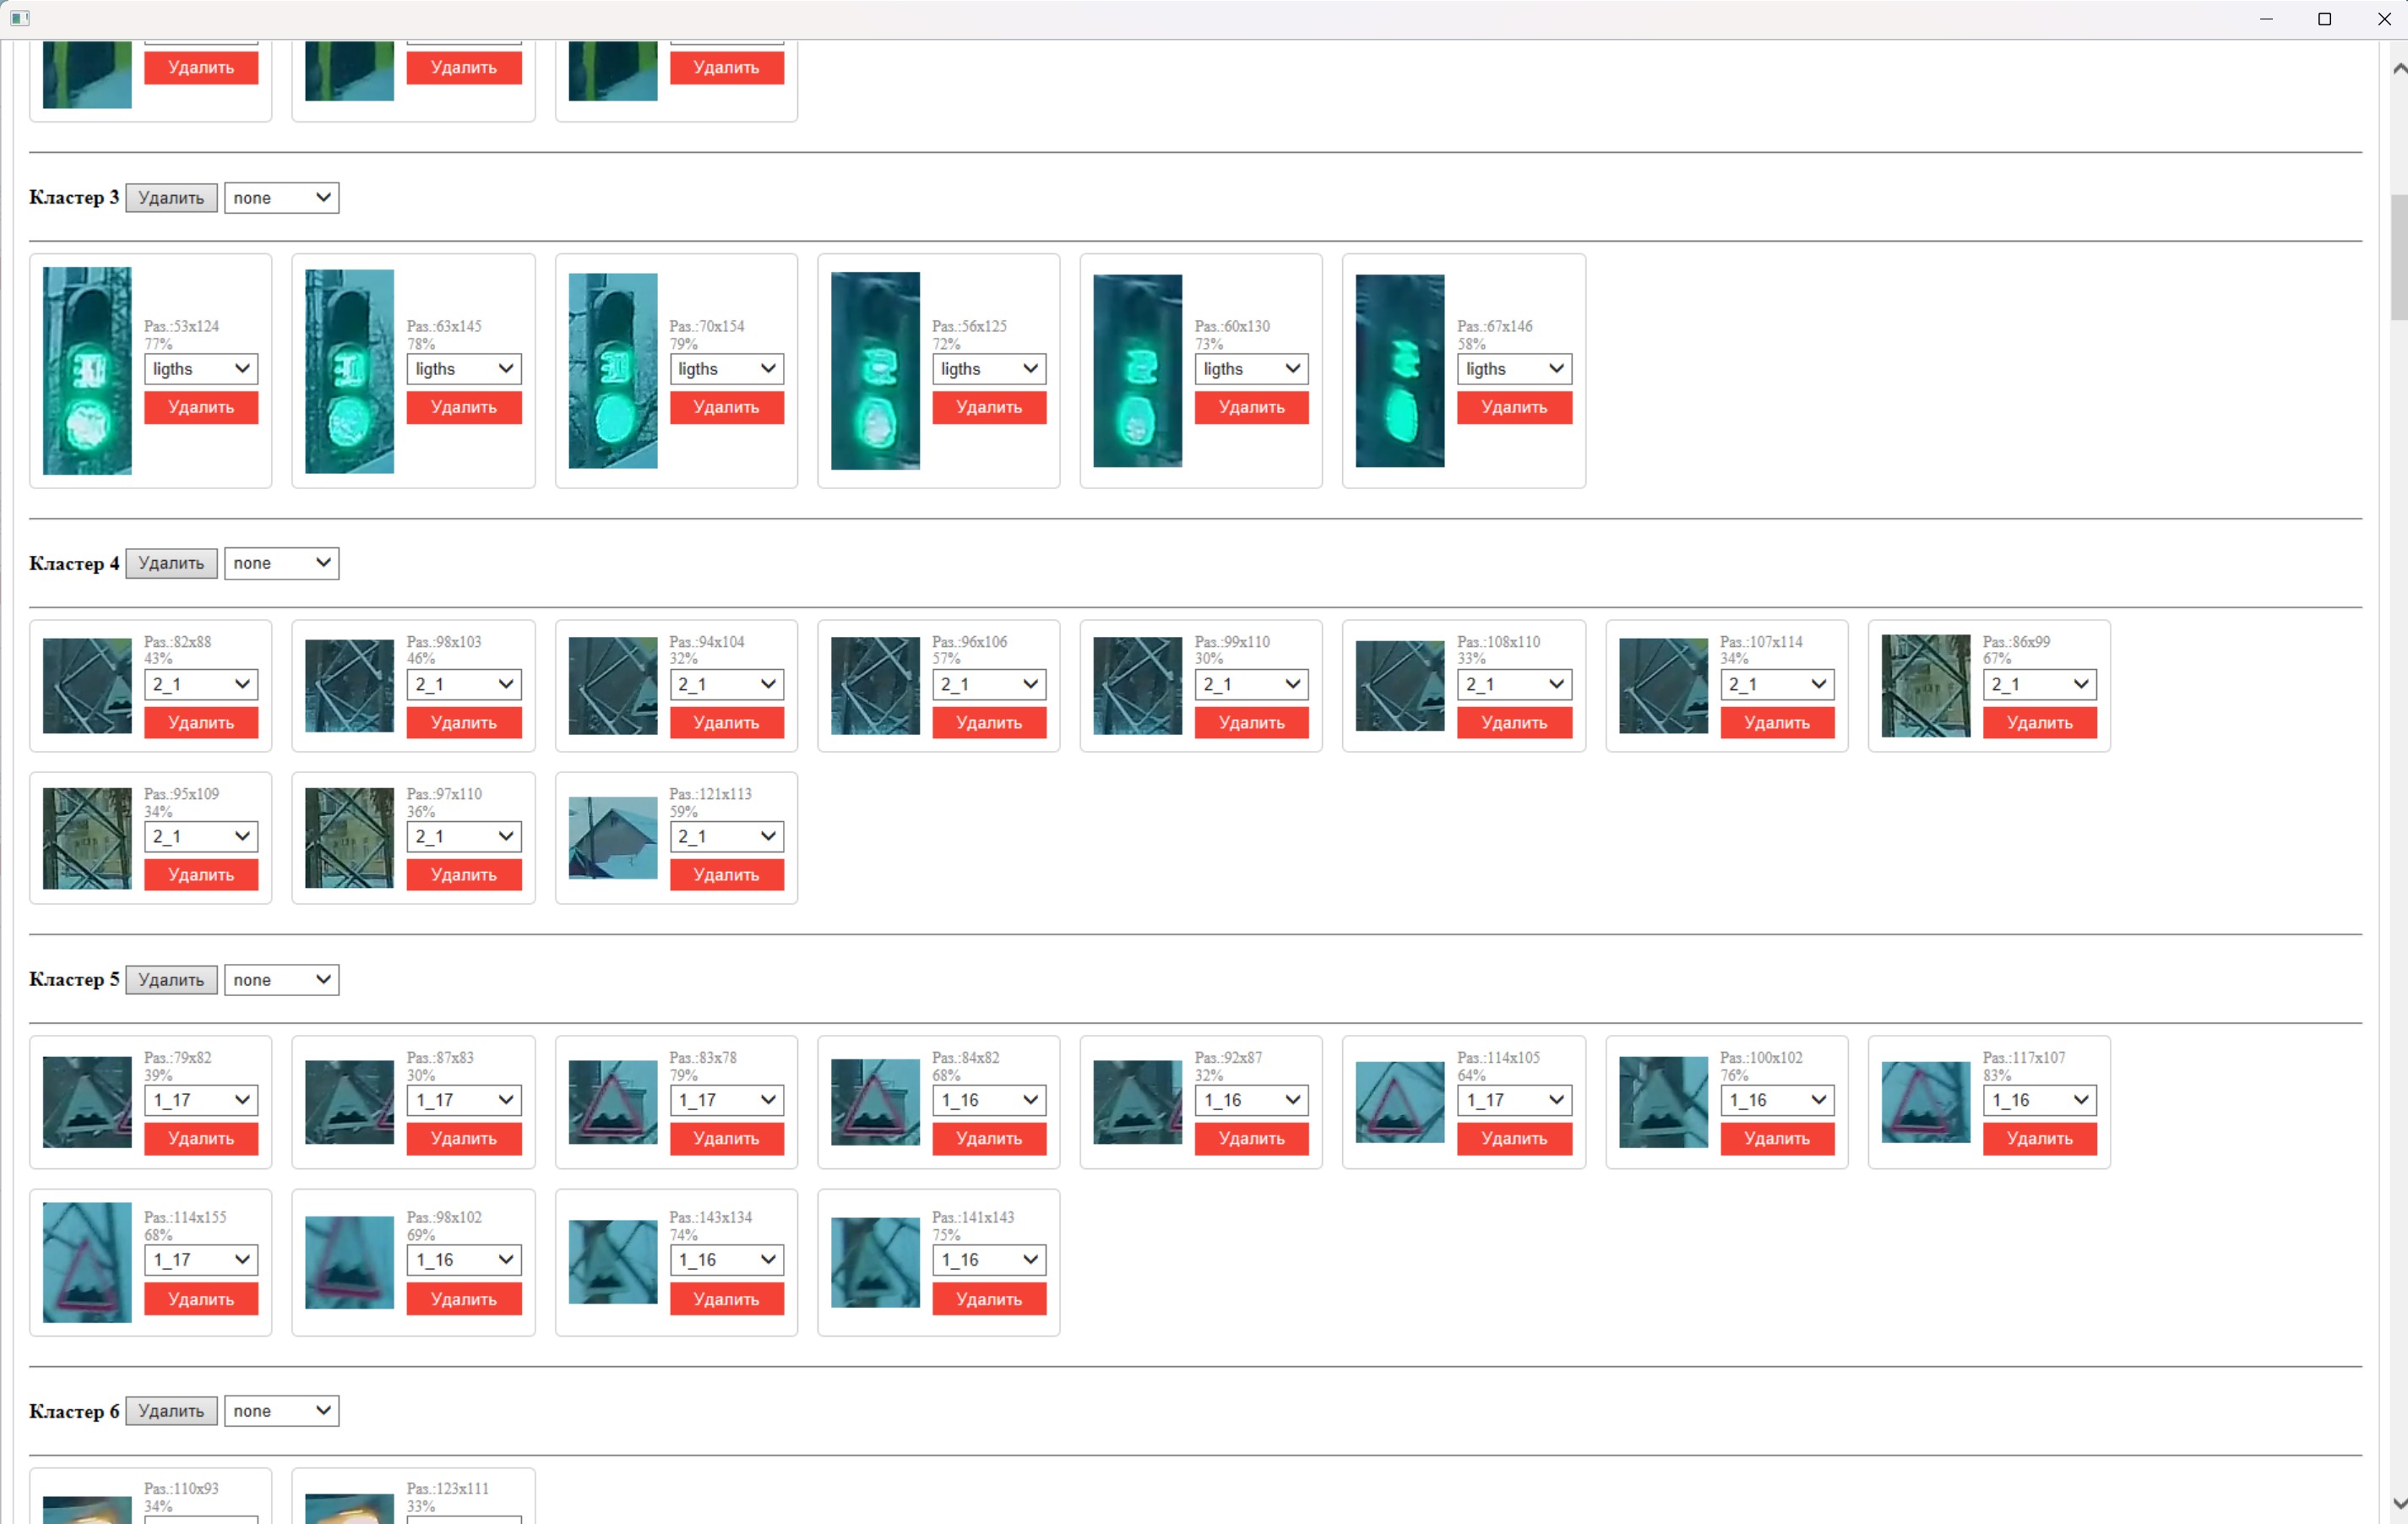
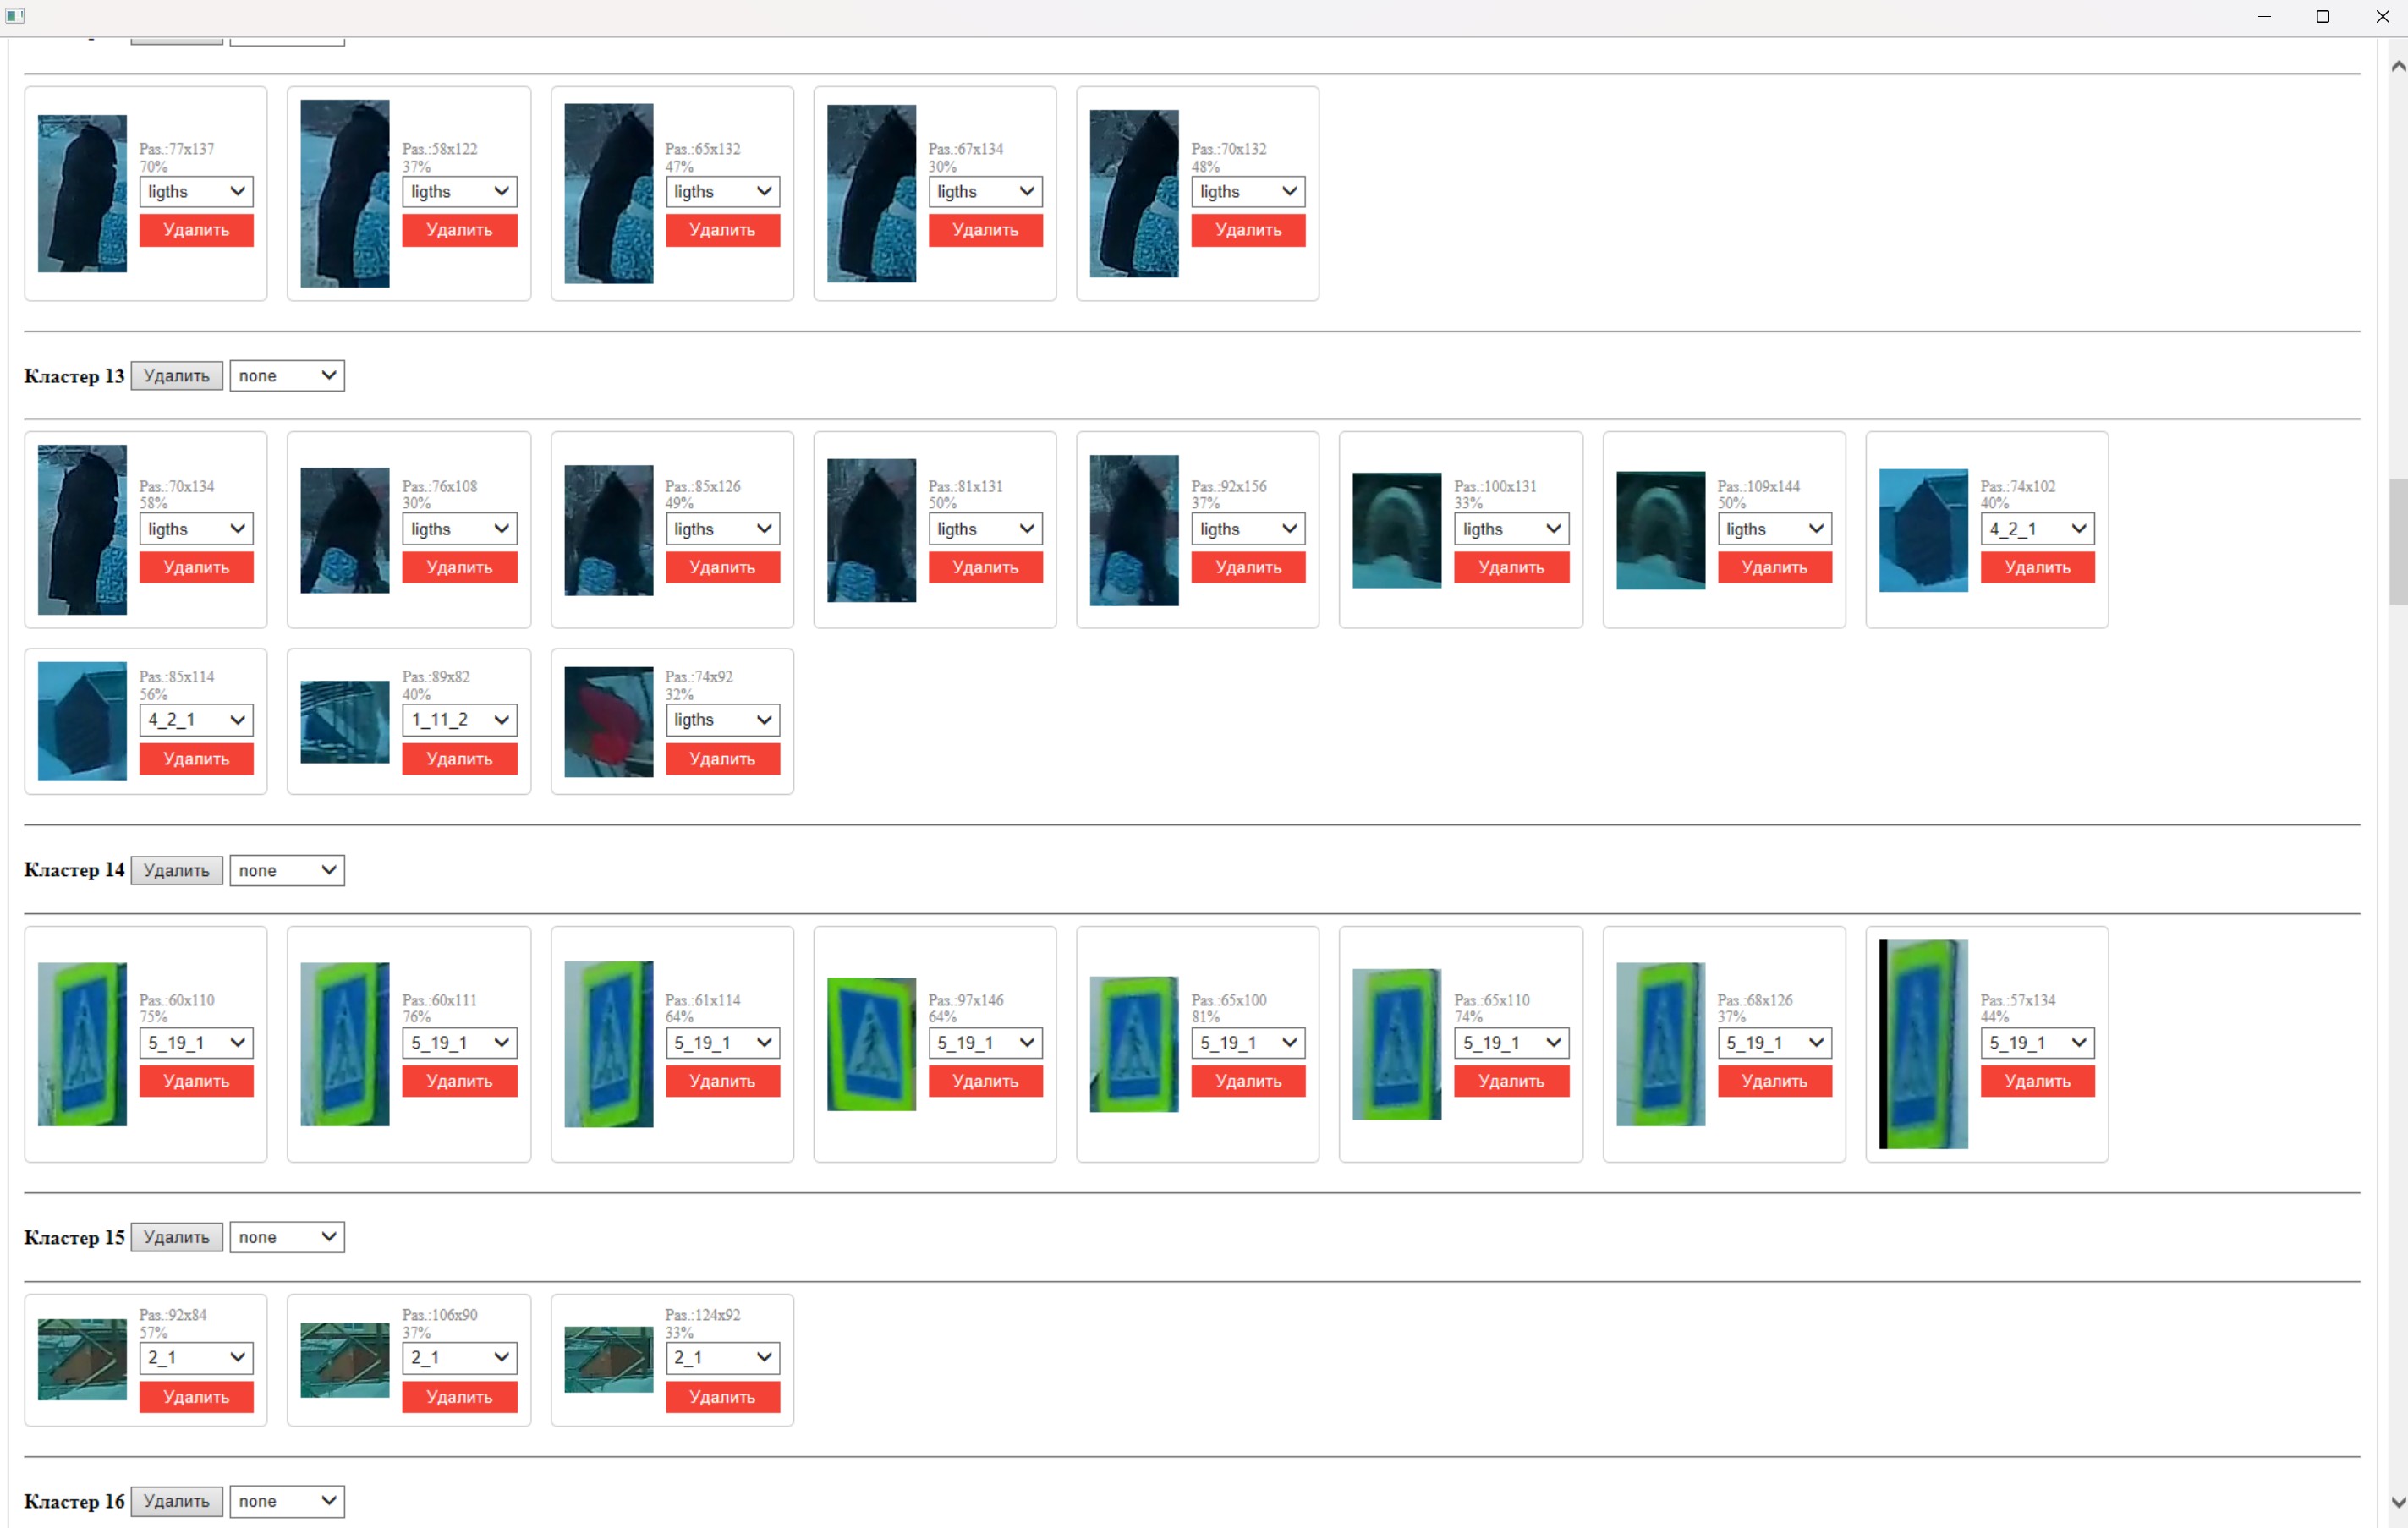
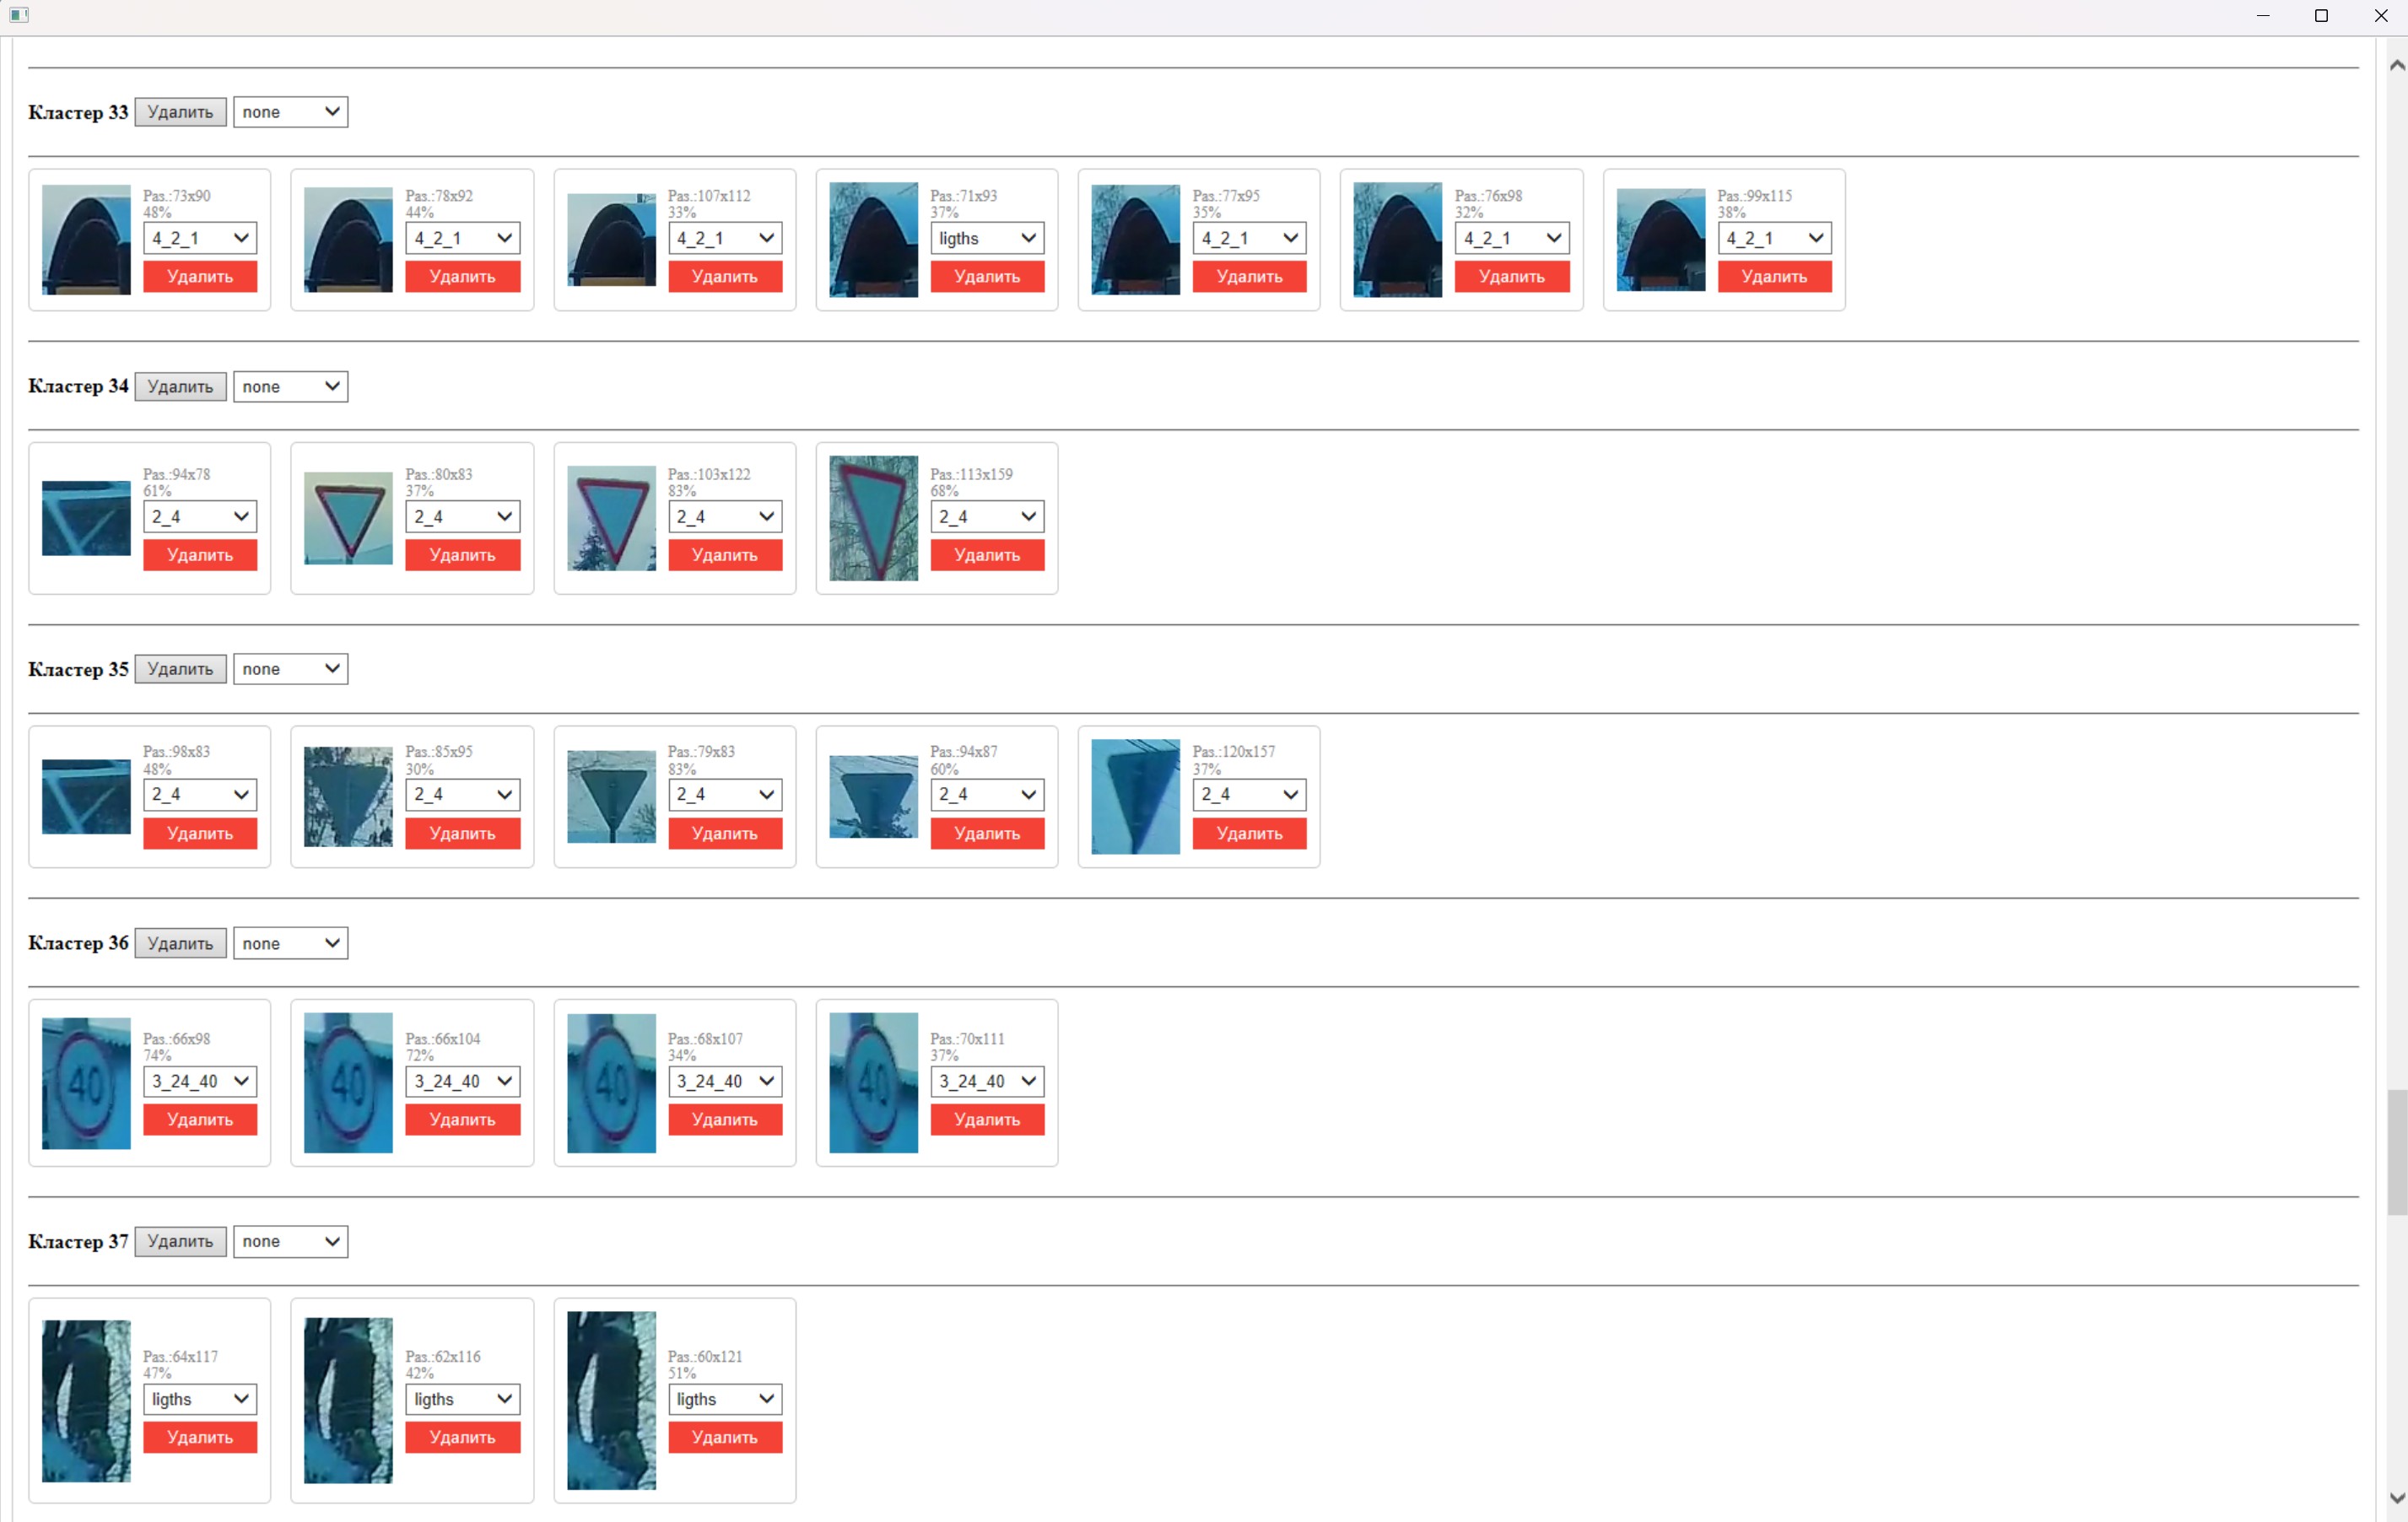
Для меня классификатор оказался полезен не только как модель распознавания, но и как инструмент контроля качества датасета.
Уточняю границы сегментатором
Из-за неточных границ знаков пришлось искать способ исправлять рамки без постоянного ручного труда. Пробовал OpenCV и поиск контуров, но этот вариант не подошёл: знаки висят на столбах и конструкциях, контур опоры связан с фоном, а универсально убрать его без потери полезной части изображения не получилось.
Тогда я обучил сегментатор и намеренно упростил ему задачу. Он не ищет знаки по всему кадру. Сначала детектор даёт приблизительный прямоугольник, приложение вырезает эту область, а сегментатор уточняет положение объекта уже внутри неё. Затем полученные координаты переводятся обратно в систему исходного кадра, а рамка дополнительно ограничивается границами изображения.
Обучающий набор формировал в той же постановке задачи. Брал не полные дорожные кадры, а вырезанные детектором объекты. В Label Studio вручную обводил нужную часть объекта полигоном, чтобы отделить её от столба и лишнего фона. После экспорта в формат YOLO разметка содержала класс и нормализованные координаты вершин контура. Так модель училась работать именно с небольшими кропами, которые позже получала в приложении.
Для обучения взял предобученную yolo11n-seg и дообучил её на своих данных: 150 эпох, размер входа 96 × 96, batch 16. Конфигурация содержит десять классов, включая знаки, светофор и автомобильный номер. Это локальное решение под уточнение рамок, а не универсальная сегментация любой дорожной сцены.
На 150-й эпохе эксперимента train7 для рамок precision составила 99,27%, recall — 99,70%, mAP50 — 99,41%, mAP50-95 — 92,10%. Для масок mAP50 составила 99,41%, mAP50-95 — 85,44%. Разница между показателями рамок и масок показывает, что найти объект и точно повторить его контур — всё же разные задачи.
Один знак — десятки детекций: пришлось писать трекер
После запуска массовой автоматической детекции появилась следующая проблема. Один физический знак попадал в длинную последовательность кадров, и модель находила его снова и снова. Если сохранять все срабатывания, датасет заполняется почти одинаковыми примерами, а ручная чистка занимает огромное количество времени.
Сначала я группировал детекции одного класса по пересечению прямоугольников в соседних кадрах. Из длинной последовательности оставлял только несколько примеров: маленький, средний и большой знак. На спокойном движении это работало, но на относительно высокой скорости объект за один кадр смещался слишком далеко. Пересечение с предыдущей рамкой исчезало, и один знак превращался в несколько независимых групп.
Поэтому я сделал собственный трекер, который прогнозирует следующие координаты. По двум последним наблюдениям рассчитывается изменение каждой стороны прямоугольника, строится прогноз на нужный кадр и только после этого сравнивается пересечение с новой детекцией. Если геометрия не помогает, используется второй канал — расстояние между эмбеддингами классификатора.
Использовать классификатор для ReID здесь оказалось оправданно: я сравниваю не все объекты сцены, а кандидатов из близких дорожек и одной области кадра. Дополнительно проверяется расстояние между прямоугольниками, чтобы не склеить два одинаковых знака. Отдельно обучать сеть ReID для этой задачи я не стал — существующая модель уже давала подходящие признаки.
Порог расстояния не выбран произвольно. На эталонных последовательностях я сравниваю последние изображения разных треков, нахожу минимальное попарное расстояние и уменьшаю его на 10%. Это эвристика под мой набор, а не гарантия устойчивости на других данных.
Готовые трекеры мне не закрывали ещё одну задачу — восстановление пропущенных детекций. Если наблюдения разделены не более чем пятью кадрами, координаты промежуточных рамок интерполируются. Такие восстановленные объекты получают conf = 0 и проходят отдельную логику отбора, чтобы не смешивать их с прямыми срабатываниями детектора.
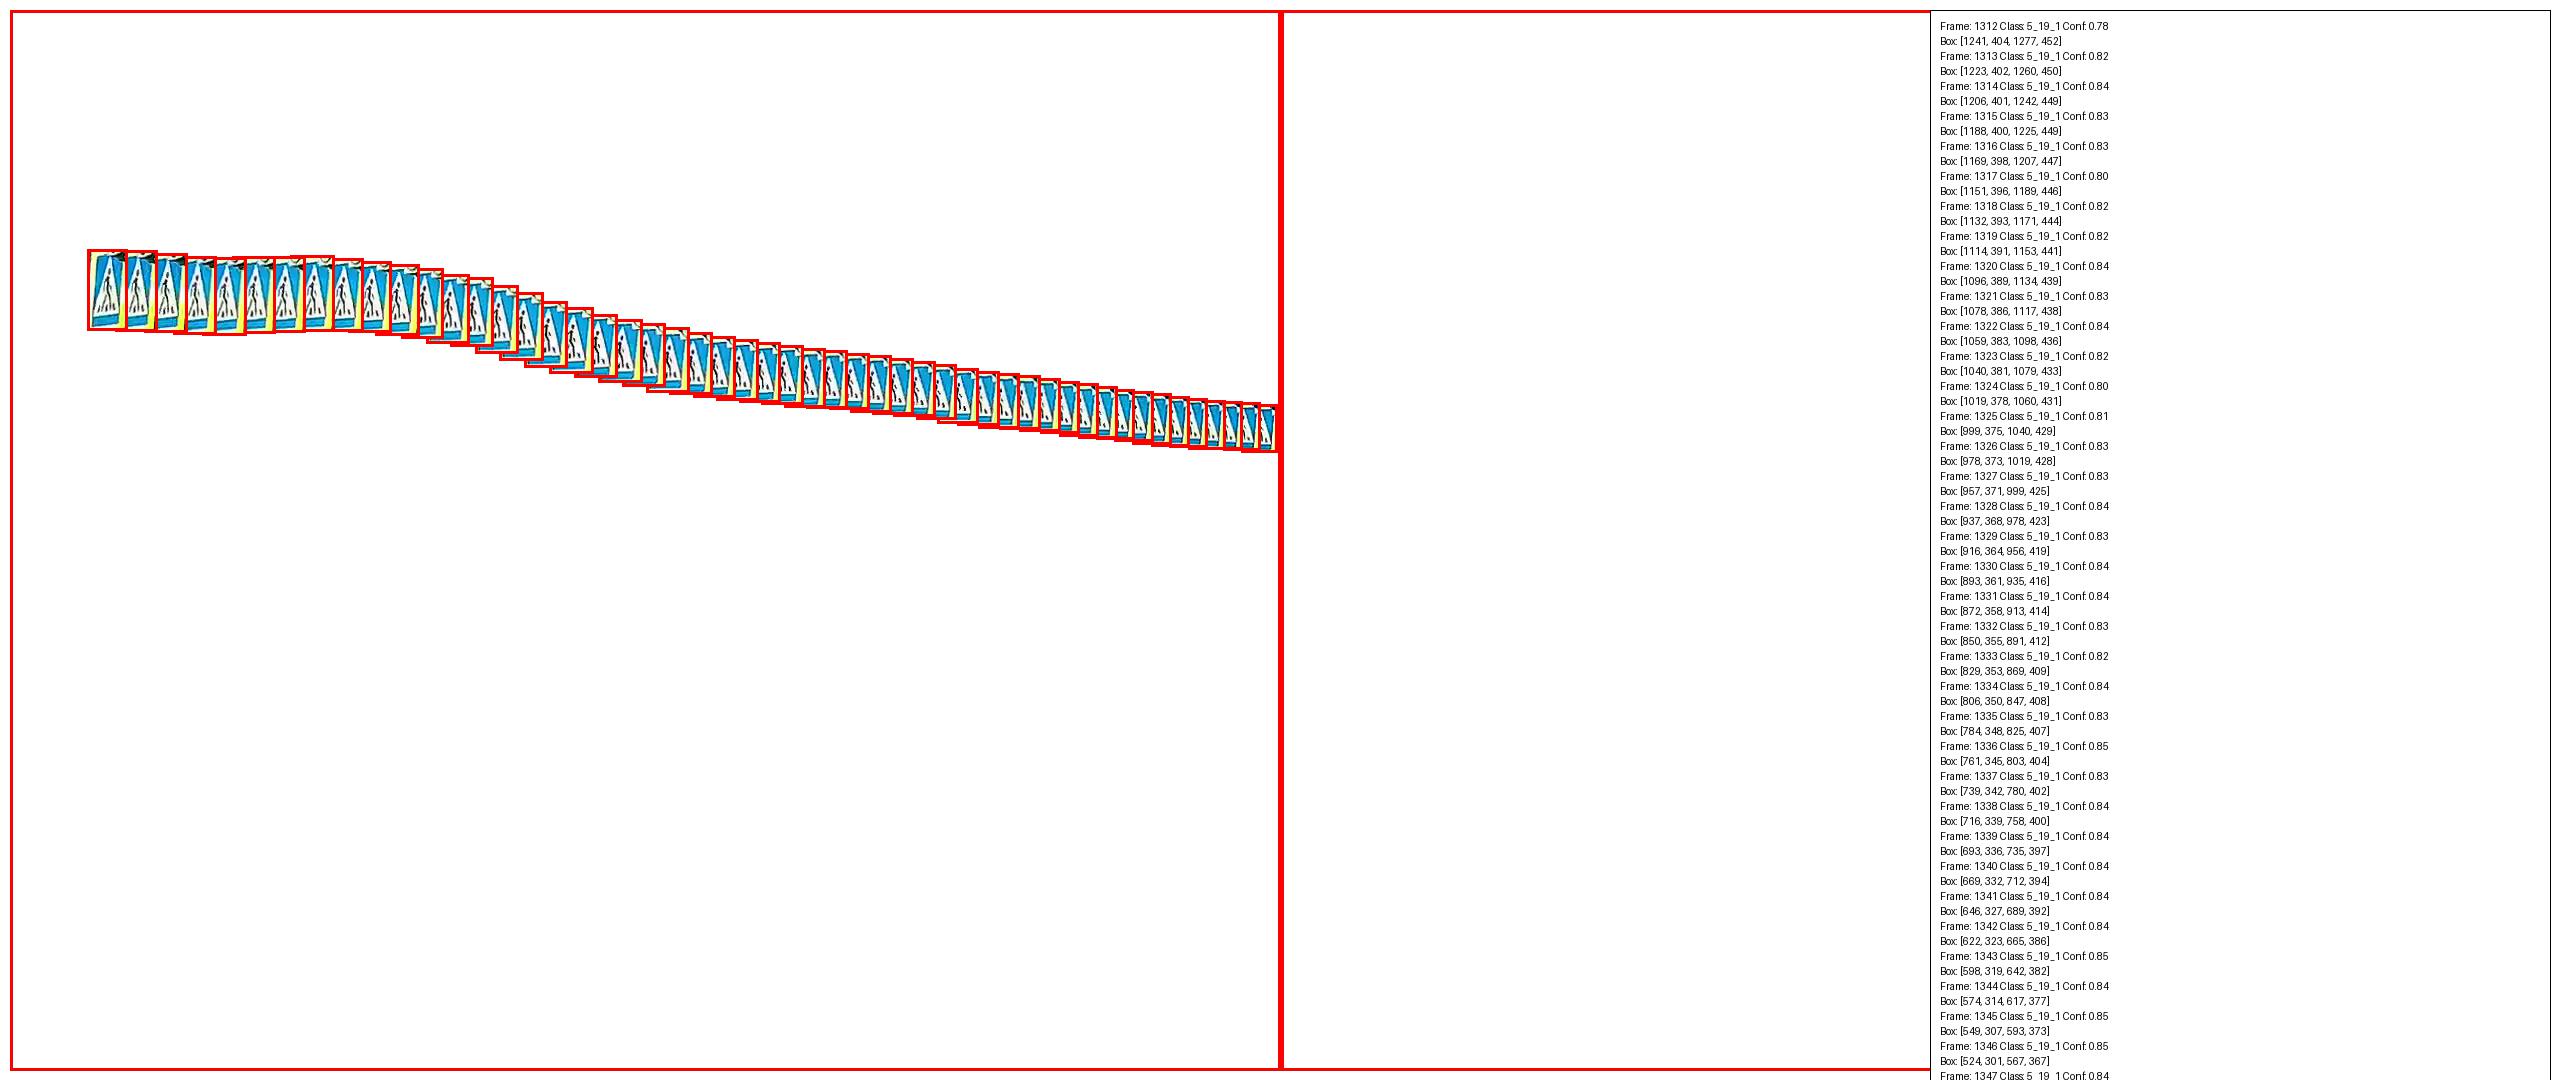
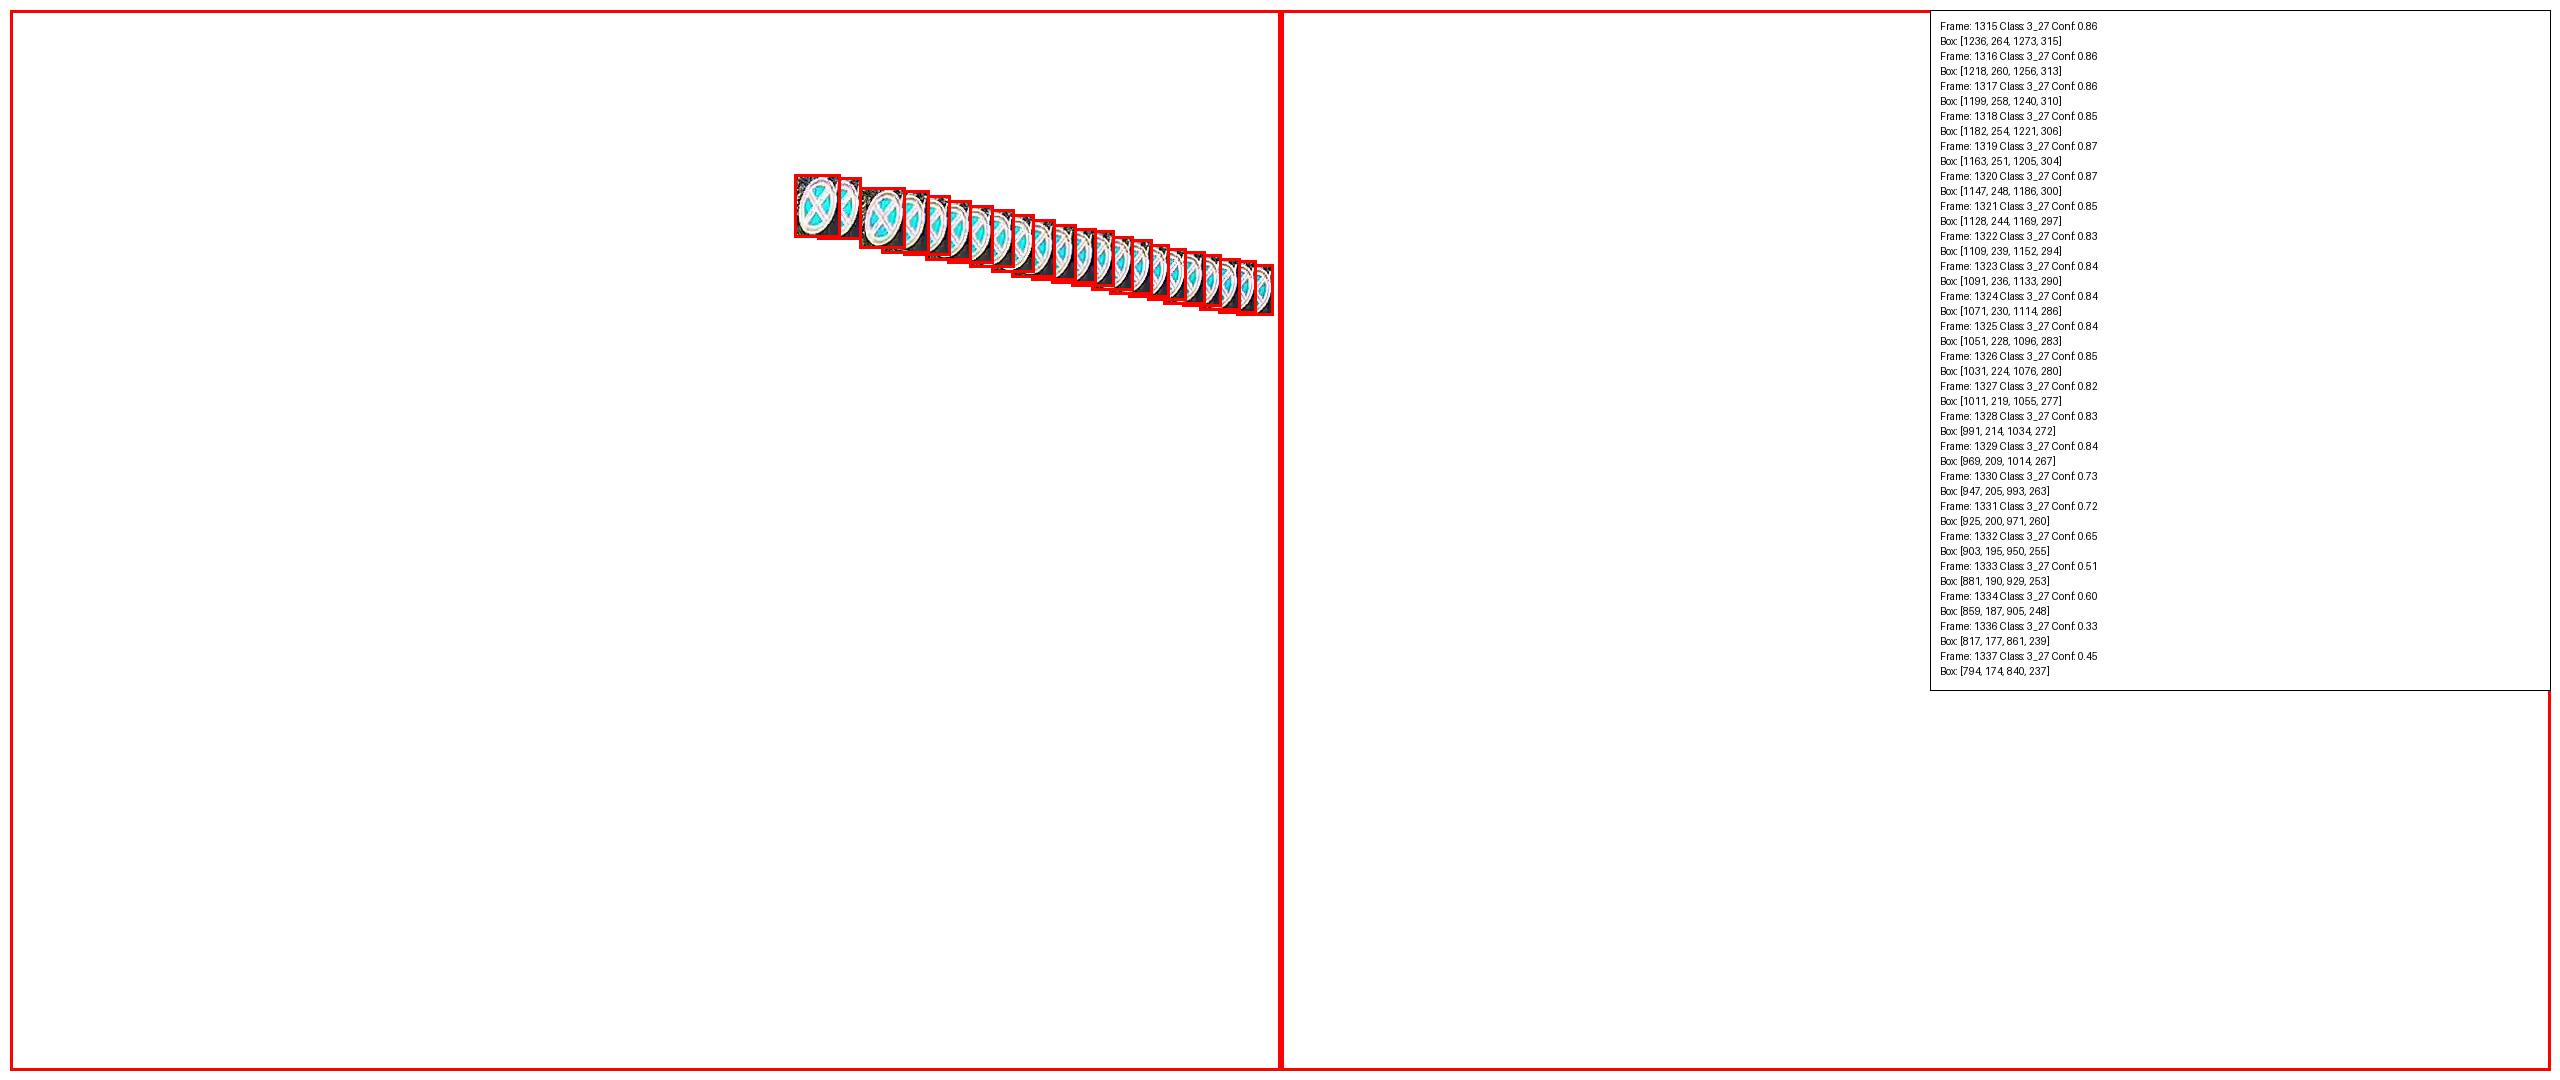
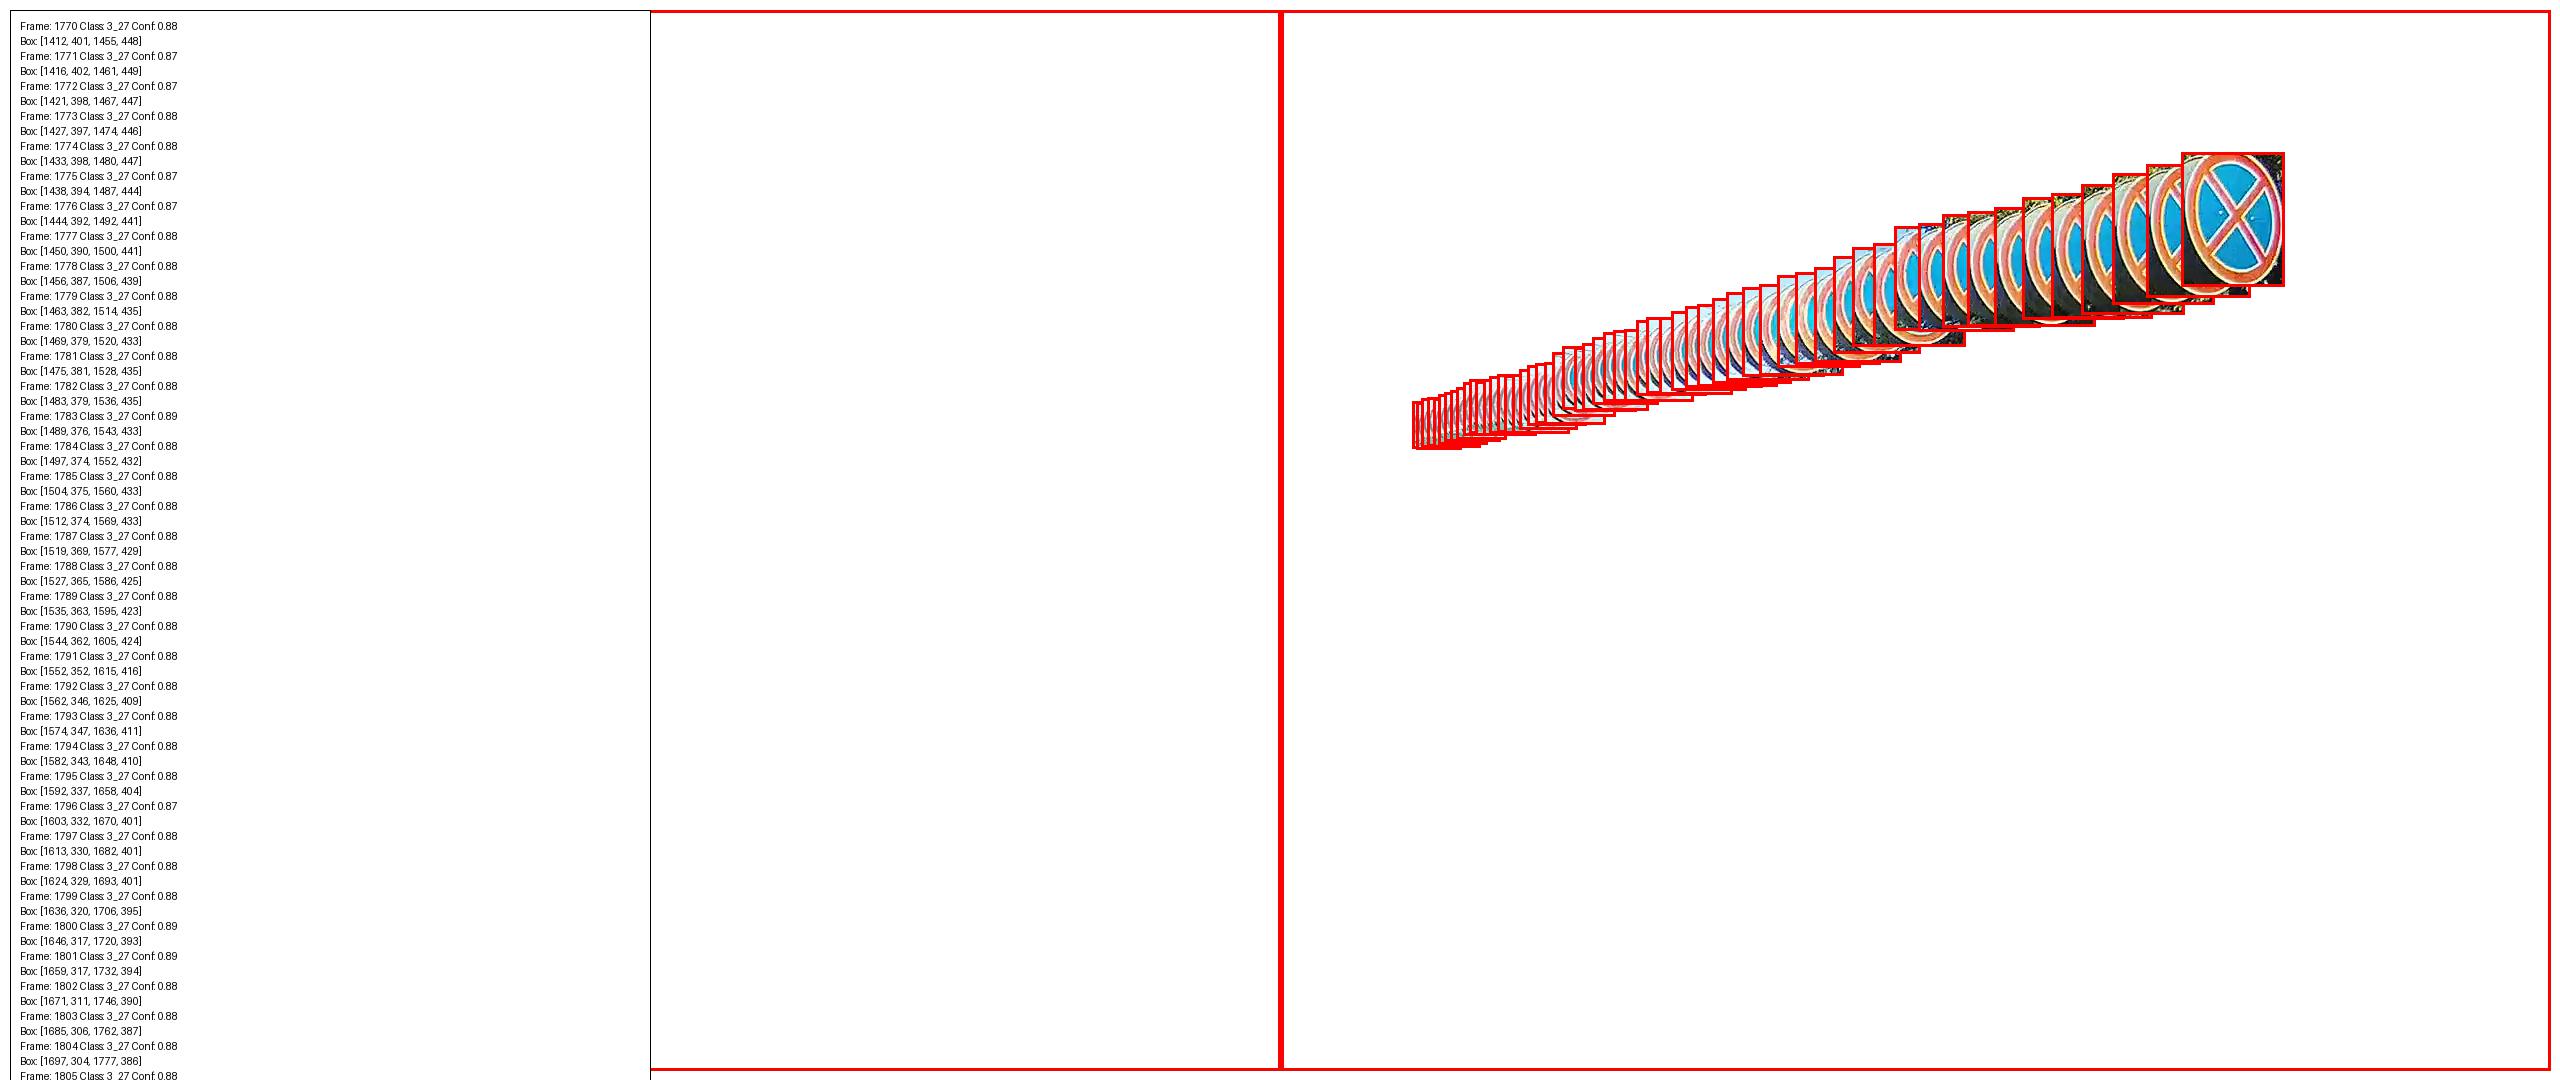
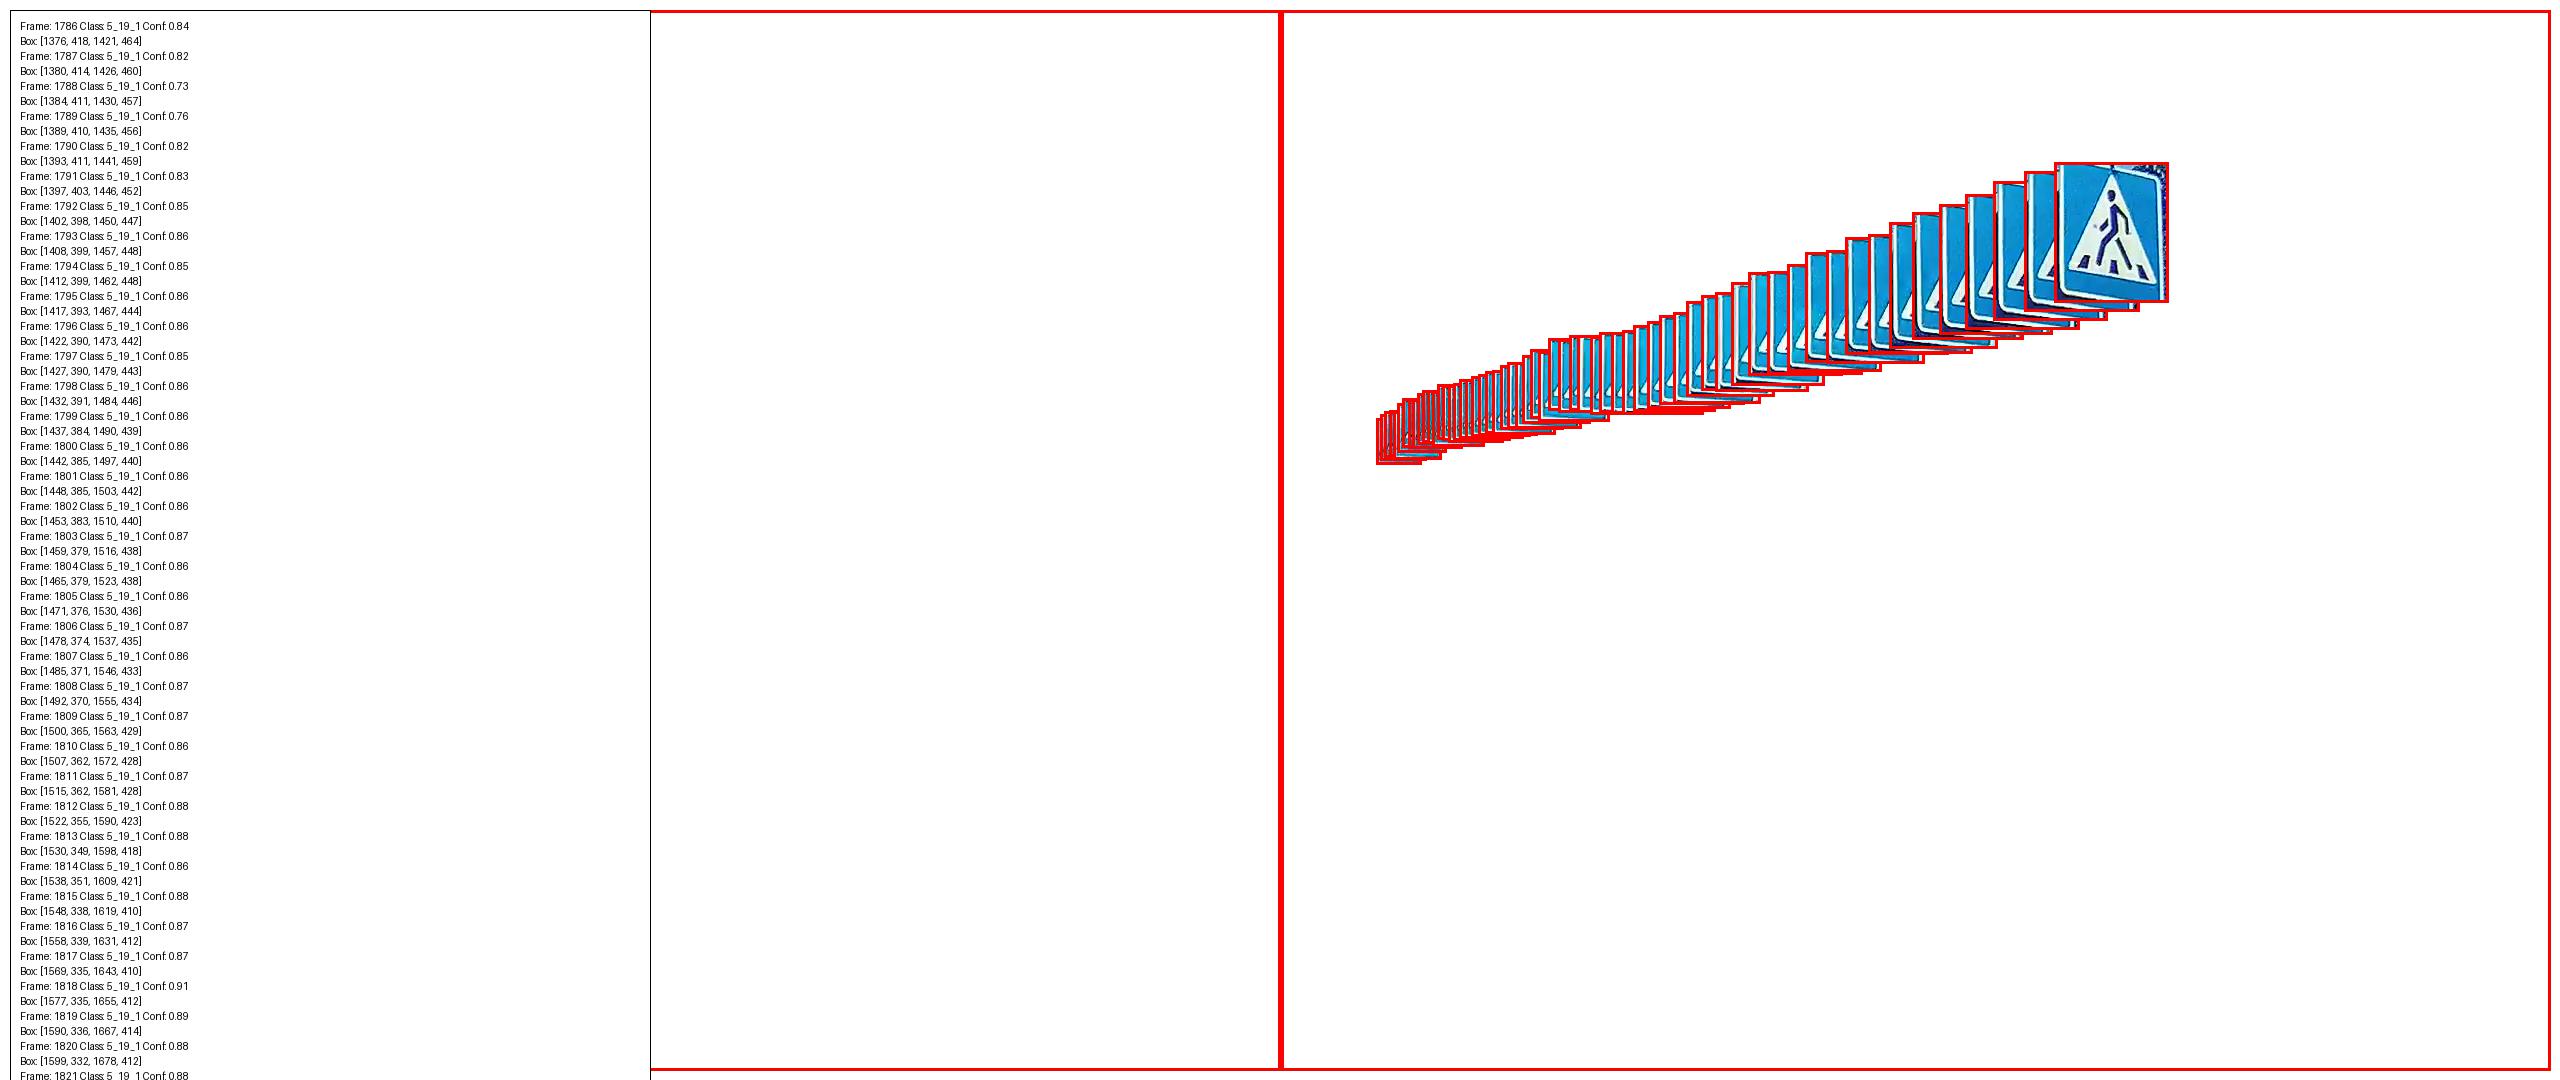
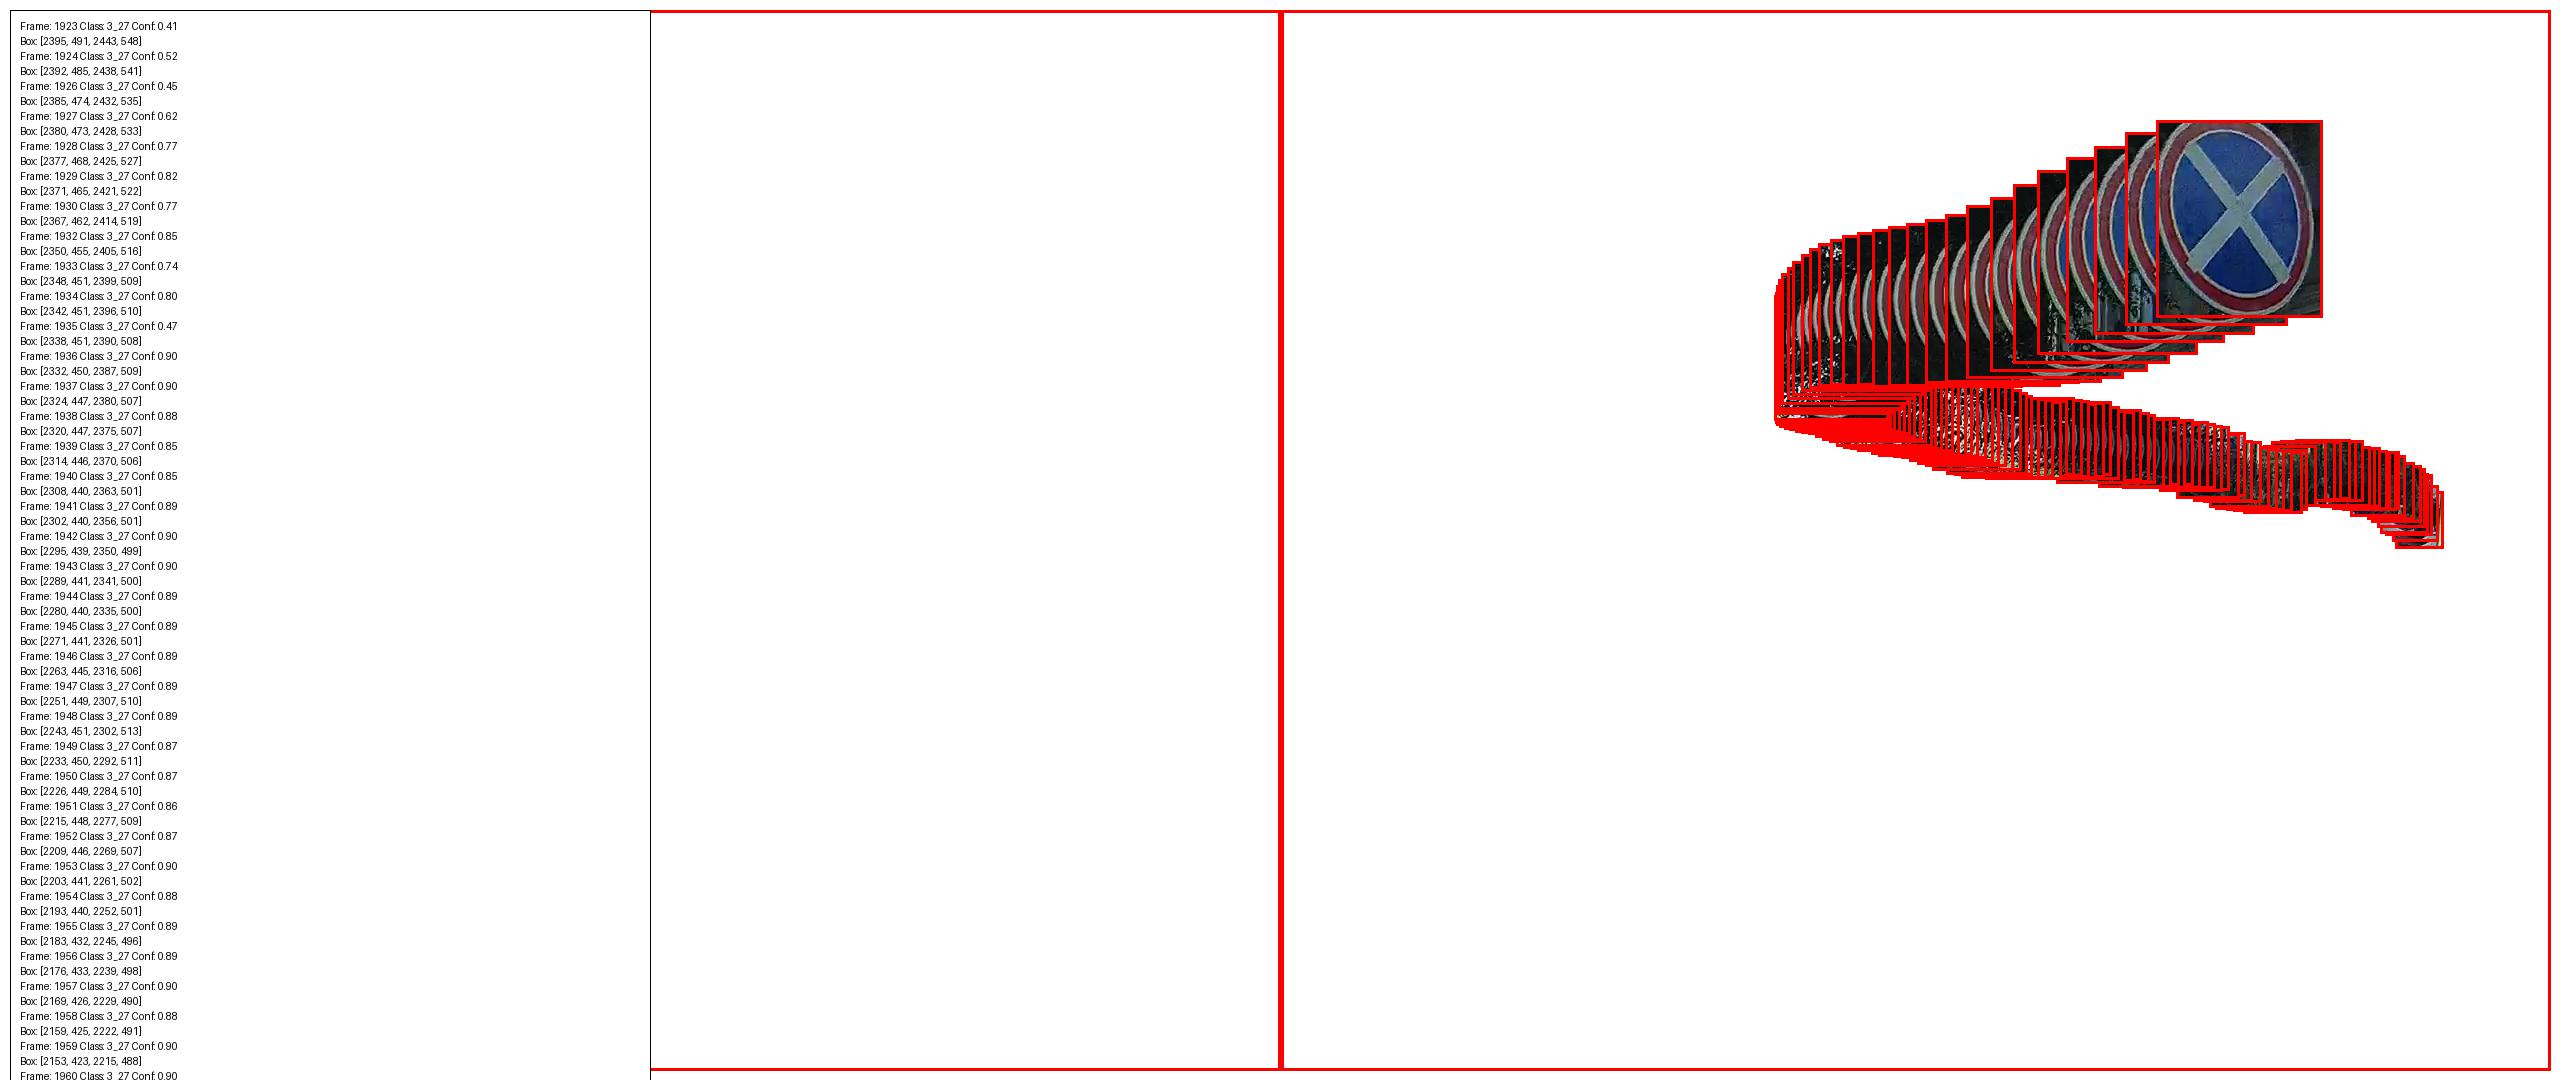
После закрытия дорожки класс уточняется по нескольким наблюдениям, а не по одному кадру. Для длинного трека используются пять из семи последних записей без двух самых последних, для короткого — доступные последние наблюдения. Избыточные детекции затем прореживаются: для длинных последовательностей оставляются отдельные точки в начале, середине и конце, а интерполированные рамки сохраняются по своему правилу.
Трекер нужен был не ради красивых идентификаторов объектов, а чтобы управлять количеством и разнообразием примеров, попадающих в датасет.
Как выглядит рабочий цикл целиком
В результате процесс перестал быть линейной схемой «видео → кадры → разметка». Он стал серией итераций, в которой каждая модель решает ограниченную задачу, а спорные места возвращаются ко мне на проверку.
- Собираю видео на разных регистраторах и в разных условиях, чтобы не привязывать набор к одной камере и одному фону.
- Запускаю детектор с относительно низким порогом и получаю кандидатов, включая ложные срабатывания.
- Объединяю наблюдения в треки, прогнозирую движение рамок и восстанавливаю короткие пропуски.
- Классификатор уточняет классы и отбраковывает фон, а его эмбеддинги помогают сопоставлять объекты и строить кластеры.
- Сегментатор уточняет границы найденных объектов внутри уже вырезанных областей.
- Прореживаю длинные треки, просматриваю кластеры и рекомендации, исправляю ошибки и только затем экспортирую данные в YOLO.
- Обучаю новую версию и повторяю цикл на новых видео, обращая внимание на классы и ситуации, которые продолжают давать ошибки.
Самое важное здесь — не количество моделей в конвейере. Если бы одна модель решала задачу достаточно хорошо, дополнительные этапы были бы не нужны. Каждый следующий компонент появлялся только после того, как на практике становилась понятна конкретная ошибка: ложные детекции, неточные рамки, повторы одного объекта или пропущенные кадры.
Что получилось на текущем срезе
В анализированном срезе основного YOLO-набора 23 575 аннотаций в train и 5 595 в val — всего 29 170. YAML объявляет 97 классов, включая дорожные знаки, светофоры и автомобильные номера; фактически в разметке присутствуют 93 класса. Для четырёх объявленных классов аннотаций пока нет.
Распределение остаётся неравномерным. В train на светофоры приходится 2 681 аннотация, на знак 5_19_1 — 2 192, на 2_1 — 1 849. При этом для самого редкого из представленных классов всего четыре аннотации. Поэтому говорить о равномерном качестве по всем классам нельзя: наполнение редких классов остаётся отдельной работой.
На 150-й эпохе эксперимента train19 precision детектора составила 97,66%, recall — 98,20%, mAP50 — 98,85%, mAP50-95 — 91,12%. Это агрегированные показатели по классам из журнала валидации: наряду с ними я продолжаю смотреть на ошибки в конкретных и особенно редких классах.
Главный результат для меня — не только сам набор. Появился повторяемый инструментарий: приложение для видео и изображений, просмотр и исправление объектов группами, автоматическая классификация, уточнение рамок, трекинг и экспорт. Новый маршрут теперь можно пропустить через уже существующий контур вместо разметки каждого кадра с нуля.
При этом ручная работа никуда не исчезла. Она переместилась от рисования каждого прямоугольника к проверке сомнительных групп, исправлению классов, анализу редких случаев и контролю экспорта. Это менее монотонная работа, но она всё ещё требует внимания и понимания предметной области.
Ограничения и что я сделал бы иначе
Первая важная вещь — разделять train и val по исходным видео или маршрутам, а не по отдельным аннотациям. Кадры одного трека слишком похожи. Если часть из них попадёт в обучение, а часть в проверку, результат будет выглядеть лучше, чем модель ведёт себя на действительно новом маршруте.
Второй момент — версионировать не только веса моделей, но и сами данные. Для каждого экспорта нужно фиксировать исходные видео, правила отбора кадров, состав классов, количество аннотаций и пересечения выборок. Это особенно важно, когда датасет пополняется итеративно и модель участвует в создании следующей версии собственных обучающих данных.
Третий момент — не оценивать досбор только числом аннотаций. Полезнее смотреть на число уникальных физических объектов, разнообразие маршрутов, размеры знаков, условия съёмки и покрытие редких классов. Десять почти одинаковых кадров одного знака не заменяют десять разных ситуаций.
И наконец, автоматические рекомендации нельзя принимать без контроля. Классификатор ошибается на нечистых кропах, сегментатор зависит от качества детектора, трекер может склеить похожие объекты, а кластеризация лишь перестраивает ошибки в другой порядок. Этот конвейер сокращает трудоёмкость, но не превращает подготовку датасета в полностью автономный процесс.
Вывод
Сбор собственного датасета оказался для меня отдельным инженерным проектом. Обучение детектора было только одной из частей. Основные усилия ушли на разнообразие исходного видео, борьбу с повторами, исправление рамок, фильтрацию фона и поиск ошибок в уже готовой разметке.
Из этой работы я вынес несколько принципов. Начинать стоит с небольшого рабочего цикла, а не с попытки сразу собрать идеальный набор. Каждую автоматизацию нужно привязывать к конкретной ручной операции, которую она сокращает. Модель может предлагать разметку, но ответственность за её принятие должна оставаться у проверяющего. И качество датасета нужно оценивать не только объёмом, но и разнообразием и чистотой разделения выборок.
Мой вариант не является универсальным: пороги, модели и правила трекинга подобраны под конкретные записи и классы. Но сам подход — постепенно строить инструменты вокруг реальных ошибок — можно переносить на другие задачи компьютерного зрения. Именно поэтому приложение и вспомогательные модели стали для меня не менее важным результатом, чем текущая версия датасета.